
 大模型与智能体DeepSeek-V4.1-Flash
资讯 · 大模型与智能体
DeepSeek-V4.1-Flash发布:552B MoE以非对称架构压缩KV缓存成本
DeepSeek发布V4.1-Flash,采用552B参数MoE和因输入、输出阶段而异的激活规模,官方称KV缓存的显存与SSD需求显著下降。
国内AI厂商与开源生态2 分钟
大模型与智能体DeepSeek-V4.1-FlashDeepSeek发布V4.1-Flash,采用552B参数MoE和因输入、输出阶段而异的激活规模,官方称KV缓存的显存与SSD需求显著下降。
沐曦与密瓜智能宣布完成llm-d适配,将国产GPU接入围绕Kubernetes构建的分布式大模型推理组件体系。
 大模型与智能体腾讯混元
腾讯发布并开源Hy4 preview,总参数770B、激活参数49B,上下文超过100万Token,面向代码、办公和科研生产力任务。
沐曦宣布曦云C系列GPU完成智谱GLM-5.3 Day-0适配,显示国产算力平台开始把新模型首发适配速度作为生态竞争指标。
 大模型与智能体GLM-5.3-Flash
智谱上线GLM-5.3-Flash,采用线性与稀疏注意力混合架构,总参数320B、激活18B,并将视觉观察纳入代码和办公Agent循环。
 算力基础设施阿里云
阿里云宣布进入Gartner云AI基础设施魔力象限领导者类别,其能力覆盖IaaS、PaaS和MaaS,反映云算力竞争正延伸至模型与平台工具链。
 芯片与硬件AI算力
北京经济技术开发区发布《AI4Chip人工智能赋能集成电路产业跨越式发展行动计划(2026—2028)》,提出面向AI基础设施和智能体场景发展通用GPU、训练与推理ASIC、RISC-V AI芯片、高端CPU、存储器及硅光互联等配套产品。本文进一步分析其对算力平台、软件生态和采购验证的影响。
大模型与智能体GLM-5.3智谱发布GLM-5.3,官方称其编程能力较上一代提高,并与国内安全团队测试代码审查和漏洞发现能力。
芯片与硬件AI算力影微创新全国总部在无锡梁溪科技城启用,当地将其作为端侧大模型AI芯片环节纳入算力、模型、芯片和终端的全栈产业体系。本文进一步分析其对算力平台、软件生态和采购验证的影响。
芯片与硬件AI算力芯擎科技宣布7纳米车规级AI加速芯片“天工100”进入量产并批量供货,采用通过PCIe接入车载系统的独立加速器形态,面向新车和存量车型提供端侧大模型算力。本文进一步分析其对算力平台、软件生态和采购验证的影响。
芯片与硬件AI算力无锡企业深存科技发布AI及数据加速处理器LakeTi P220和大模型可扩展计算平台XThor X400。当地披露上半年智能算力总规模为15619P,并形成多项垂直行业模型。本文进一步分析其对算力平台、软件生态和采购验证的影响。
算力基础设施AI算力移动云长三角(苏州)Token中心揭牌,提出从算力互联、模型汇聚和应用赋能三个方向建设,并通过模型服务网统一纳管和调度并网算力。本文进一步分析其对算力平台、软件生态和采购验证的影响。
 科研与高校成果沐曦
7月24日7时33分, “力箭一号” 遥十五运载火箭在东风商业航天创新试验区成功将智能计算卫星“云尖沐曦号”(“吉天星A-04星”)发射入轨。“云尖沐曦号”卫星是由之江实验室联合沐曦股份、云尖信息、巡天千河、浙大城市学院等合作单位共同研制的智能计算卫星,该卫星实现了从设计制造到卫星运行、管控的全链路智能。此次,卫星搭载了基于沐曦GPU芯片的智算载荷、星载路由器和激光通信机。
 开发框架与软件生态沐曦
作为核心合作伙伴,沐曦股份携手上海人工智能实验室,基于DeepLink团队推出的KernelSwift深度共创,重点支持Triton算子优化、Clike算子优化两大赛道 ,聚焦国产芯片环境下的算子开发与性能优化,与开发者共同探索算子生成、迁移与优化的新路径。其中, Clike算子优化路线由沐曦股份团队联合打造 ,已集成至KernelSwift平台。在沐曦GPU搭建的实际硬件环境验证中,经 沐曦MXMACA算子优化后,Clike算子达到2
 开发框架与软件生态沐曦
沐曦股份首次以双展区形式亮相大会,集中发布多项重磅成果 :首发曦景S系列超节点与曦索X300系列科学智能GPU,联合十大开源社区及产业伙伴展示国产算力生态建设成果,并全面呈现人工智能在千行百业的落地实践。从智算基础设施到科学智能,从开源生态到行业应用,沐曦股份持续完善覆盖芯片、系统、软件到产业落地的全栈技术体系,为人工智能产业高质量发展提供自主、安全、高效的算力支撑。本届WAIC上,沐曦股份正式发布曦景S系列超节点产品,以高算力密度、高
 芯片与硬件壁仞科技
大会期间,壁仞科技全景式呈现技术创新的硬核实力: 重磅首发推出NPO光互连、分布式解耦架构、最大1024卡超节点方案 ,并荣获世界人工智能大会SAIL奖系列荣誉。与此同时,壁仞科技与众多顶尖专家学者及产业界人士齐聚一堂,共话行业发展大势;近日,在2026世界人工智能大会上,中兴通讯联合曦智科技、壁仞科技以及多家合作伙伴, 凭借“基于OEX+dOCS架构的国产高性能Matrix超节点”项目荣登SAIL榜单,斩获本届SAIL之星奖项 。
 芯片与硬件超节点
7月17日-20日,2026世界人工智能大会(WAIC)正式在上海拉开帷幕,壁仞科技正式推出 下一代NPO光互连、分布式解耦架构超节点方案,支持单个超节点1024卡Scale-up扩展 。壁仞科技联合创始人、首席技术官洪洲与AI框架架构副总裁丁云帆分别发布重磅演讲,系统展示了壁仞科技从芯片、协议、系统到应用的完整1024卡超节点方案。7月18日上午,洪洲在《优化GPU超节点——GPU芯片互联技术创新与工程实践》主题演讲中,系统性地阐述了
 开发框架与软件生态MiniMax
今日,MiniMax 正式开源多模态生成模型 MiniMax H3。同日,摩尔线程基于 AI 训推一体智算卡 MTT S5000 及 MUSA 软件栈, 率先完成 H3 的极速适配与高效运行 。作为 MiniMax 首款开源多模态生成模型 ,H3 突破了传统单一任务的边界,能在多模态上下文中统一理解创作意图,支持文本、图片、音频和视频的多元输入,可直出 2K 分辨率、最长 15 秒的原生音画内容。
 芯片与硬件AI算力
长鑫科技于2026年7月27日在科创板上市。相比单纯讨论股价,更值得关注的是募集资金、先进DRAM工艺、产能建设以及AI服务器内存需求之间的产业联系。
大模型与智能体AI算力月之暗面开放Kimi K3模型权重、技术报告及配套基础设施。本文从MoE架构、激活参数、上下文、量化和部署门槛分析其对国内开源模型生态的意义。
 政策与产业动态AI算力
全国产10万卡人工智能超集群投入使用,标志国产算力基础设施进入更大规模工程验证阶段。真正决定集群价值的仍是网络、存储、软件栈、稳定性和有效利用率。
 大模型与智能体世界模型
WAIC 2026 期间,摩尔线程与世界模型领军企业极佳视界(GigaAI)宣布达成战略合作:摩尔线程全功能 GPU 已经与极佳视界的具身世界模型完成训练与推理验证,运行结果与国际主流算力平台高度对齐。双方宣布,将以此次验证为起点,持续深化战略合作——以国产全功能 GPU 为底座,以通用世界模型为牵引,“国芯+国模”强强联手,共同打造自主可控的通用世界模型全球标杆。这意味着,物理 AGI 时代最消耗算力、也最关键的 “世界模型训练” 环
算力基础设施AI算力截至2026年6月底,我国智能算力规模达到2185 EFLOPS(FP16),同比增长177%,算力设施整体上架率为71.4%。本文分析这些指标对算力供给和项目选型的实际意义。
 算力基础设施摩尔线程
从双展区到主题论坛,从硬核产品、标杆案例到生态联动,摩尔线程 以“展区可感、论坛可知、生态可验证”的立体化呈现,向产业界展示了国产 GPU 从底层芯片、万卡集群到全场景落地的完整能力闭环。这不仅是摩尔线程全栈通用技术实力的集中展现,更标志着全功能 GPU 正全面迈入赋能企业实际应用的高质量规模化落地阶段。在 WAIC 展区,除了智算卡、服务器到边缘与智能终端的硬件矩阵展示,摩尔线程还将算力转化为“三大 AI 工厂”直观的空间交互,系统呈
 大模型与智能体摩尔线程
7 月 18 日,作为 2026 世界人工智能大会(WAIC)分论坛之一,摩尔线程“词元时代 万物智能”主题论坛在上海世博展览馆举行。会上,摩尔线程创始人、董事长兼首席执行官张建中系统介绍了三大“AI 工厂”的落地部署及最新进展。摩尔线程创始人、董事长兼首席执行官张建中在演讲中表示,基于摩尔线程夸娥(KUAE)智算集群打造的三大“AI 工厂”——“模型训练工厂” “词元生产工厂” “智能体生产工厂”,凭借显著的全场景通用优势,支撑从训练
 芯片与硬件昇腾950
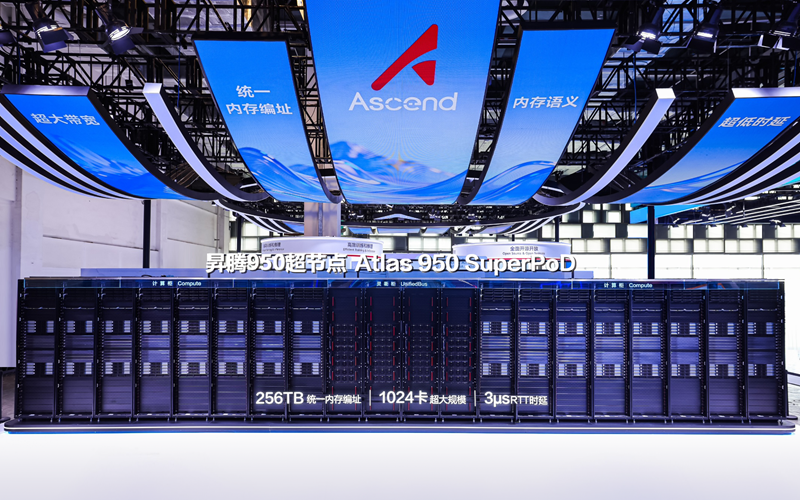
华为在2026世界人工智能大会展示Atlas 950 SuperPoD真机,系统规模达到1024卡,并公布FP8、FP4算力、全局统一内存和互联时延等关键指标。
 大模型与智能体Kimi K3
月之暗面发布Kimi K3,模型总参数2.8万亿,采用KDA、Attention Residuals和高稀疏MoE,官方建议在64张以上加速卡超节点上部署。
 科研与高校成果摩尔线程
7月9日, 摩尔线程携手柳州高级中学、柳州市第八中学及智都科技打造的“AI 教育实训基地”,在柳州市第八中学正式揭牌成立 。作为 国内率先落地初中、打通初高中人才贯通培养的全国产“AI 教育实训基地” ,该基地依托摩尔线程 AI 算力本 MTT AIBOOK,构建“初中 AI 启蒙、高中培优进阶”一体化育人通道,让学生在基础教育阶段即可接触并实操前沿 AI 技术,旨在解决 AI 教学“有理论缺实践、学段培养断层”的痛点,打造“ AI +
 科研与高校成果沐曦
6月30日,沐曦股份迎来了一群特殊访客—— 清华大学电子工程系“沪智E行”实践支队 ,正式开启了为期两日的深度校企实训之旅。此次已是清华大学第四批赴沐曦股份开展产业实践的学生支队。沐曦股份董事兼南京公司总经理王爽首先对清华大学师生一行的到来致以热烈欢迎。
 开发框架与软件生态沐曦
7月6日,腾讯混元研发的快慢思考融合的混合专家模型 Hy3 正式发布并开源, 沐曦股份曦云 C 系列 GPU 率先完成Day 0 全链路适配 。依托沐曦股份全栈自研 MXMACA 软件栈,企业可实现零代码快速部署,一站式解锁 Hy3 代码、智能体、超长文档全场景业务能力。曦云C系列GPU基于沐曦股份自研核心GPU IP打造,具备高能效比与高通用性,精准匹配大模型的超大规模参数处理及长上下文推理需求。
腾讯混元Hy3正式版采用295B总参数、21B激活参数和256K上下文,强调快慢思考融合、工具调用与真实产品反馈。
 开发框架与软件生态LongCat
7月6日, 美团新一代万亿参数大模型 LongCat-2.0 正式宣布开源。此次适配覆盖模型加载、推理引擎拉起、关键算子优化、部署验证与精度校验等全链路环节,使 LongCat-2.0 能够在 MTT S5000 上实现稳定、高效的推理运行,为开发者和企业客户提供更便捷的模型部署路径。摩尔线程技术团队依托高性能 SGLang-MUSA 推理引擎及 MUSA 软件生态,围绕 LongCat-2.0 的模型结构和推理特性,快速完成从框架兼容
 大模型与智能体LongCat
7月6日,美团宣布正式开源新一代万亿参数大模型 LongCat-2.0。依托“自研GPU硬件+MXMACA全栈软件”的软硬一体技术优势, 沐曦股份率先完成曦云 C 系列 GPU对LongCat-2.0 Day 0 深度适配 。LongCat-2.0代表国产大模型正式迈入工业级落地新阶段,对国产通用GPU的算力吞吐、显存容量、长文本推理、多卡协同调度等能力提出了极高要求。
 开发框架与软件生态开源
人工智能浪潮奔涌向前,开源正是驱动AI技术创新与生态共建的核心引擎。作为国产AI算力的代表力量, 沐曦股份 联合CCF开源发展技术委员会、木兰开源社区、启悟学习社区与AI Infra开源社区,携手中国光华科技基金会青年开源基金, 正式启动“青年开源专项基金种子计划” 。有沐曦股份、CCF开源发展技术委员会等多方权威平台联合背书,入选项目不仅能拿到资金,还能获得行业资源对接与传播曝光,更有机会深度融入国产AI开源生态——这正是沐曦股份希望
 大模型与智能体GLM
6月16日晚,智谱正式开源新一代旗舰模型GLM-5.2,壁仞科技壁砺™166系列基于vLLM推理框架完成该模型的 “Day0”适配与调优 ,率先向广大开发者及用户提供快速部署方案,以及高效稳定的长程任务体验。根据官方介绍,GLM-5.2是智谱迄今能力最强的开源模型。凭借自研全栈多智能体编排平台 SUPACODE 以及成熟的 BIRENSUPA™ 软件栈,壁仞科技快速实现GLM-5.2模型适配与调优。
 科研与高校成果摩尔线程
6月24日,北京大学计算机学院产学研沙龙现场,北京大学与摩尔线程正式签署合作协议,宣布共建 “北大-摩尔线程智能图形与仿真联合实验室” (以下简称“联合实验室”)。该实验室将聚焦图形渲染、物理仿真、空间智能、3D高斯重建(3DGS)与具身智能等前沿领域的关键技术攻关,同步支撑基础科学研究,通过软硬一体化深度协同,推动从底层芯片到上层应用的全栈性能优化,为空间智能与具身智能产业构建坚实的国产化技术底座。摩尔线程作为 国内极为稀缺的具备软硬
 大模型与智能体摩尔线程
今天,2026上海世界移动通信大会(简称“MWC上海”)正式开幕,聚焦6G、移动AI、具身智能等前沿领域。摩尔线程作为北京优质科技企业代表,在大会上展示了从智算集群到终端设备的多元产品和解决方案,覆盖“云边端”全场景 ,系统呈现了公司在大模型训练和推理、科学计算、端侧智能以及具身智能等领域的技术突破与创新实力。在云端智算方面 ,摩尔线程展示了专为大模型训练、推理及高性能计算设计的 AI 训推一体智算卡 MTT S5000 ,支持从 FP
 开发框架与软件生态训练
近日,由中国光华科技基金会青年开源专项基金公益支持,沐曦股份联合AI Infra 开源社区、TileAI 社区、GitLink平台、启悟学习社区、联合DataWhale等多家头部AI开源相关平台和社区,共同推出的 TileLang Puzzle 开源训练营,已圆满完成线上教学阶段 。作为业界第一个系统性讲授 TileLang 算子开发与优化的实战型开源课程,本次训练营成功吸引了全国 551 名开发者参与,在国产 AI 底层人才培养领域取
 开发框架与软件生态GLM
6月17日,摩尔线程宣布在 AI 训推一体全功能 GPU 智算卡 MTT S5000 上,完成对 智谱新一代开源旗舰模型 GLM-5.2 的 Day-0 极速适配 。此次适配延续了摩尔线程在 GLM-5.1 长上下文 Prefill 与 P/D 异构分离推理场景中的优化积累,并 面向 GLM-5.2 超长上下文与复杂推理负载,进一步释放 MTT S5000 在长输入 Prefill 阶段的高吞吐优势。摩尔线程技术团队基于高性能 SGLa
 开发框架与软件生态推理
支持 1M 无损上下文,长程任务能力显著提升,减少复杂任务中的上下文漂移与目标遗忘Coding 与长程任务评测达到开源 SOTA,在复杂系统工程、深度调试中表现更稳真实开发体感显著提升,项目级上下文承载、工程规范遵循与多端开发更可靠。
 大模型与智能体MiniMax
6月12日晚,MiniMax正式开源新一代通用模型MiniMax M3,壁仞科技 壁砺™166系列 基于SGLang推理框架 完成该模型的 “Day0”适配与调优 。壁仞科技以全栈技术能力支持国产AI生态建设,此前已同步高效适配MiniMax M2.1、M2.5、M2.7等多款模型,并在模型精度和稳定性方面表现优异。根据官方介绍,MiniMax M3采用全新的自研稀疏注意力架构 MSA( MiniMax Sparse Attention
大模型与智能体GLM-5.2智谱上线GLM-5.2,支持100万Token上下文并强化长程Coding任务,重点解决大型项目中的目标遗忘和上下文漂移。
 大模型与智能体摩尔线程
作为国内领先的国产全功能GPU企业, 摩尔线程深度参与大会 , 多位技术专家在多个论坛及Open Talk环节发表演讲 ,系统呈现覆盖“云-边-端”的软硬协同全栈创新成果:▼ 在大模型产业论坛, 摩尔线程带来《面向大模型时代的智能计算:万卡集群大模型训练实践》主题演讲。▼ 在智算前沿-AI赋能系统论坛, 摩尔线程带来《TiLISA& MTX:打造支撑多DSL的编译后端》技术分享。
 政策与产业动态壁仞科技
6月8日,根据香港交易所发布公告, 壁仞科技(06082.HK)将纳入至香港交易所科技100指数。2026年1月2日,壁仞科技正式在香港联合交易所挂牌上市,成为港股GPU第一股。6月8日,壁仞科技正式纳入 恒生综合指数 ,并同步调入 港股通 标的名单。
 开发框架与软件生态MiniMax
同日,摩尔线程旗舰级 AI 训推一体智算卡 MTT S5000 已完成对该模型的 Day-0 极速适配 。这是国产大模型与国产算力芯片完成适配的又一例证,也彰显了摩尔线程凭借 原生 FP8 算力底座与高效 MUSA 软件生态 ,对前沿大模型需求的即时响应与稳定支撑能力。MiniMax M3 是目前国内唯一同时具备前沿Coding & Agentic能力、超长下文与原生多模态的开源大模型,也是第一个将完整frontier能力带入开放世界的
 政策与产业动态壁仞科技
6月5日,根据上交所最新公告, 国内领先的通用智能计算解决方案提供商 壁仞科技 (06082.HK)正式纳入港股通标的名单 ,内地合格投资者自6月8日起可通过港股通交易壁仞科技港股股票。壁仞科技正式纳入港股通后,有望进一步提升公司在港股市场的流动性,丰富股东结构,加深与内地资本市场联动,为后续吸引更多机构投资者、扩大投资者基础创造有利条件。2026年1月2日,壁仞科技正式在香港联合交易所主板上市,成为港股GPU第一股。
 开发框架与软件生态壁仞科技
5月29日,阶跃星辰正式发布并开源Step 3.7 Flash。凭借壁仞科技自研的全栈多智能体编排平台SUPACODE与BIRENSUPA™的协同优势,壁砺™ 166M在Step 3.7 Flash模型发布后, 基于vLLM推理框架快速完成Day0适配 ,实现高效稳定运行,为广大开发者及用户提供开箱即用、快速部署方案以及Step 3.7 Flash的“首发体验”。Step 3.7 Flash基于壁砺™ 166M完成多模态推理任务。
开发框架与软件生态AI算力华为云发布AICS智算集群、AMS记忆存储、CCE Volcano Next调度引擎和AgentSphere智能体运行环境,围绕Token生产、长期记忆、训推调度与智能体隔离构建基础设施。本文进一步分析其对算力平台、软件生态和采购验证的影响。
政策与产业动态AI算力《“人工智能+信息通信”创新发展实施意见(2026—2028年)》提出建设枢纽、区域、边缘三级协同算力设施,发展400Gbps与800Gbps骨干传输、智算云服务和统一算力标识体系。本文进一步分析其对算力平台、软件生态和采购验证的影响。
开发框架与软件生态AI算力华为在2026数据通信创新峰会中国站升级星河AI网络,提出面向Token生产的高算效、高可用数据中心网络,并强化智能体访问和网络安全能力。本文进一步分析其对算力平台、软件生态和采购验证的影响。
 算力基础设施AI数据中心
华为提出面向企业AI规模化落地的数据中心建设框架,将数据湖、知识与记忆平台、算力、模型、Agent框架和数据韧性纳入统一规划。
大模型与智能体AI算力阿里巴巴集团在2026年5月公布面向智能体时代的新AI芯片、旗舰模型和重构后的云计算技术栈,将芯片、模型与云服务作为一体化能力推出。本文进一步分析其对算力平台、软件生态和采购验证的影响。
 政策与产业动态壁仞科技
5月19日,壁仞科技(06082.HK)与万达信息(300168.SZ)正式签署生态战略合作框架协议。双方将依托壁仞科技高性能、自主可控的通用GPU产品及智算集群规模化部署能力,结合万达信息丰富的行业场景资源与解决方案落地经验,共同打造国产化与智能化的行业标杆解决方案,加快国产AI产业生态建设,推动 我国智能经济高质量发展。壁仞科技 是国内领先的通用智能计算解决方案提供商,以自主研发的壁砺™系列GPU产品为核心,为各行业提供强大、安全
 算力基础设施AIDC
面对超节点功率密度上升,华为提出源网荷储协同的AIDC方案,强调供电、制冷、储能和算力负载需要统一规划。
 芯片与硬件摩尔线程
摩尔线程公布基于PH100芯片和平湖架构的MTT S5000,覆盖FP8至FP64,并强调PyTorch、vLLM、SGLang适配及集群扩展。
 芯片与硬件壁仞科技
为夯实国产算力人才培育根基,实现人才能力与产业需求的精准匹配,壁仞科技联合模力方舟于近期重磅推出 AI技能认证 。目前,壁仞科技认证专区 初级L1认证 已面向在校学生及中级开发者开放。作为国内领先的通用智能计算解决方案提供商,壁仞科技本次推出的AI技能认证体系具备四重核心价值:。
 科研与高校成果中国科大
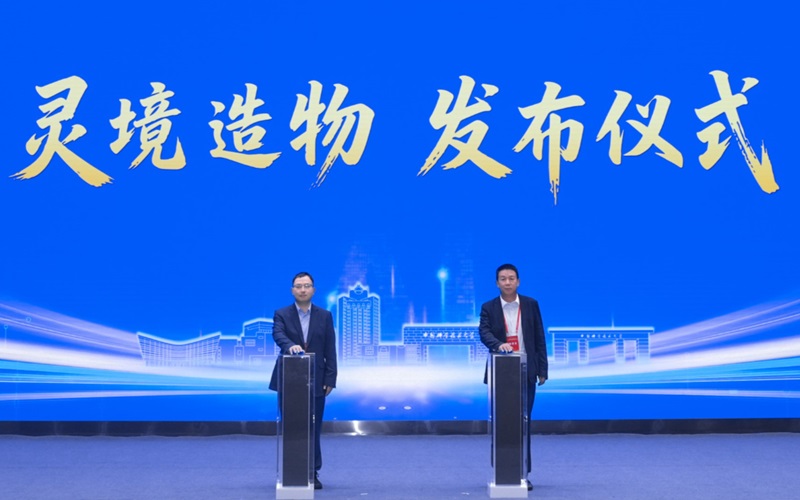
中国科学技术大学与华为联合发布智能科研工具“灵境造物”,尝试将需求理解、文献阅读、实验设计、自动计算和机器实验形成可迭代流程。
大模型与智能体AI算力华电乌江联合华为等伙伴发布“乌江睿算”水电场景大模型,将气象模型与水文机理结合,用于气象、径流和功率预测等场景。本文进一步分析其对算力平台、软件生态和采购验证的影响。
 大模型与智能体DeepSeek-V4
DeepSeek开放V4预览版并将上下文扩展至100万Token,长上下文能力进入可用阶段,但并发容量、KV缓存和检索策略成为部署重点。
 大模型与智能体DeepSeek
今天,我们全新系列模型 DeepSeek-V4 的预览版本正式上线并同步开源。DeepSeek-V4 拥有百万字超长上下文,在 Agent 能力、世界知识和推理性能上均实现国内与开源领域的领先。即日起登录官网 chat.deepseek.com 或官方App,即可与最新的 DeepSeek-V4 对话,探索 1M 超长上下文记忆的全新体验。
算力基础设施AI算力华为在MWC 2026发布Atlas 950 SuperPoD、Atlas 850E及TaiShan超节点产品。官方称Atlas 950以单柜64卡为基本单元,最大支持8192张NPU高速互联。本文进一步分析其对算力平台、软件生态和采购验证的影响。
 算力基础设施智算集群
华为发布端到端算力部署与优化服务,覆盖机房基础设施、集群集成、模型适配和性能调优,并披露1024卡超节点上线周期等工程数据。
 开发框架与软件生态开源
【西班牙,巴塞罗那,2026年2月28日】在MWC26 巴塞罗那期间,华为首次在海外展示最新的Atlas 950 SuperPoD, TaiShan 950 SuperPoD 等多个型号超节点产品和解决方案,并强调坚持开源开放,携手产业界共建开放共赢的计算产业生态,打造坚实的算力底座,为世界提供新选择。随着 AI 技术持续迭代演进,大模型参数规模已迈入万亿级时代,智能体(Agentic AI)深度融入各行各业生产核心环节,对算力强度与时
 大模型与智能体训练
Agent 自由度受限 :将 Agent 视为白盒就要求在 Agent 和 RL Framework 之间共享和传递状态。这种设计难以对复杂的 Agent 架构(如动态上下文管理、Multi-Agent RL等)进行建模,导致模型能力无法在复杂的黑盒Agent上有效泛化。Token 一致性问题 :现有的 TITO(Token-In-Token-Out)模式迫使 Agent 与底层的 Tokenizer 逻辑深度耦合。
 大模型与智能体大模型
1月22日,百度发布并上线原生全模态 大模型 文心5.0正式版。该模型参数达2.4万亿,采用原生全模态统一建模技术,具备全模态理解与生成能力,支持文本、图像、音频、视频等多种信息的输入与输出。目前,百度千帆平台已支持企业用户和开发者便捷调用文心5.0。
 大模型与智能体MiniMax
MiniMax Speech 2.8:赋予 AI 语音“人的温度”MiniMax Speech 2.8:赋予 AI 语音"人的温度"今天,我们正式推出全新的语音大模型 MiniMax Speech 2.8。
政策与产业动态AI算力工信部提出到2026年底实现31个省区市及重点算力企业资源数据自动化监测,建设覆盖全国、标准统一的算力态势感知体系。本文进一步分析其对算力平台、软件生态和采购验证的影响。
大模型与智能体DeepSeekDeepSeek V3.2 正式版:强化 Agent 能力,融入思考推理DeepSeek-V3.2 的目标是平衡推理能力与输出长度,适合日常使用,例如问答场景和通用 Agent 任务场景。DeepSeek-V3.2 的目标是平衡推理能力与输出长度,适合日常使用,例如问答场景和通用 Agent 任务场景。
 大模型与智能体MiniMax
MiniMax Hailuo 2.3 视频复杂表现新高度 & Media Agent。
大模型与智能体DeepSeekDeepSeek-V3.2-Exp 发布,训练推理提效,API 同步降价作为迈向新一代架构的中间步骤,V3.2-Exp 在 V3.1-Terminus 的基础上引入了 DeepSeek Sparse Attention(一种稀疏注意力机制),针对长文本的训练和推理效率进行了探索性的优化和验证。目前,官方 App、网页端、小程序均已同步更新为 DeepSeek-V3.2-Exp,同时 API 大幅度降价 ,欢迎广大用户体验测试并向我们反馈
 大模型与智能体开源
发布包括47B、3B激活参数的混合专家(MoE)模型,以及0.3B参数的稠密型模型等10款模型,并实现预训练权重和推理代码的完全开源。目前开源模型API服务也可在百度智能云千帆 大模型 平台使用。本次发布的全部模型(包括预训练权重和推理代码)和项目均已完全开源至Hugging Face(。
大模型与智能体DeepSeekDeepSeek-R1 发布,性能对标 OpenAI o1 正式版今天,我们正式发布 DeepSeek-R1,并同步开源模型权重。DeepSeek-R1 遵循 MIT License,允许用户通过蒸馏技术借助 R1 训练其他模型。
大模型与智能体DeepSeek今天,我们全新系列模型 DeepSeek-V3 首个版本上线并同步开源。当前版本的 DeepSeek-V3 暂不支持多模态输入输出。DeepSeek-V3 为自研 MoE 模型,671B 参数,激活 37B,在 14.8T token 上进行了预训练。
 科研与高校成果AI算力
[深圳,中国,2024年8月27日] 近日,华为宣布正式发布“华为AI百校计划”,旨在为国内高等院校提供基于昇腾云服务的AI算力资源,用以支持算子、算法、模型推理、大模型训练等开发场景,为高校师生提供科研AI算力平台、实践机会,促进产学研结合,推动AI在教育领域的落地与普及,助力高校在AI领域的科研创新、技术合作和人才培养。作为科技发展的前沿领域,人工智能正在加速推动社会各方面的改变,给人类带来了巨大的便利和福祉。从智能语音助手到自动驾
大模型与智能体DeepSeekDeepSeek API 创新采用硬盘缓存,价格再降一个数量级在大模型 API 的使用场景中,用户的输入有相当比例是重复的。为此,DeepSeek 启用上下文硬盘缓存技术,把预计未来会重复使用的内容,缓存在分布式的硬盘阵列中。
大模型与智能体DeepSeekDeepSeek API 升级,支持续写、FIM、Function Calling、JSON Output更新接口 /chat/completions JSON Output Function Calling 对话前缀续写(Beta) 8K 最长输出(Beta)DeepSeek API 新增 JSON Output 功能,兼容 OpenAI API,能够强制模型输出 JSON 格式的字符串。
 大模型与智能体大模型
[中国,上海,2024年7月5日] 近日,2024世界人工智能大会在上海世博中心开幕,华为常务董事、华为云CEO张平安在产业发展主论坛上发表主题演讲。他表示,中国的AI发展离不开算力基础设施的创新,并且要敢于开放行业场景,让AI在行业应用上领先。华为正在通过云网端芯架构上的协同创新,来构建可持续发展的AI算力基础,包括芯端算力上云、面向AI的网络架构升级、云基础设施系统架构创新三个方面。
 大模型与智能体大模型
[中国,香港,2024年4月24日] 在2024年APEC中国工商理事会香港论坛上,华为公司轮值董事长胡厚崑发表了题为“拥抱人工智能 赋能千行百业”的演讲。胡厚崑强调“如何用好人工智能”已成为企业的必答题,并提出了三项帮助企业用好人工智能技术的建议:率先在信息密集型与大量重复型业务场景中应用AI,以便其尽快发挥价值;充分借助已有的大模型(如华为盘古大模型),以降低企业模型开发的难度。
 开发框架与软件生态行业展会
2021年4 月 22 、 23 日,寒武纪与众多行业合作伙伴联袂首次亮相“中国高速公路信息化大会暨技术产品展示会”(简称 CEIC )。截至 2021 年 4 月,中国高速公路通车里程超过 16 万公里,稳居世界第一。但中国高速公路的起步比较晚, 1984 年才启动了第一条高速公路(沈阳至大连高速公路)的建设。
 开发框架与软件生态行业展会
2021年6月17日,寒武纪亮相2021上海国际交通工程、智能交通技术与设施展览会。寒武纪MLU220-SOM荣获亚洲智能交通旗舰展2021年度“创新产品”殊荣。