
资讯 · 芯片与硬件
沐曦曦云C系列完成GLM-5.3 Day-0适配:国产GPU追赶模型发布节奏
沐曦宣布曦云C系列GPU完成智谱GLM-5.3 Day-0适配,显示国产算力平台开始把新模型首发适配速度作为生态竞争指标。
国内AI厂商与开源生态2 分钟
沐曦宣布曦云C系列GPU完成智谱GLM-5.3 Day-0适配,显示国产算力平台开始把新模型首发适配速度作为生态竞争指标。
 芯片与硬件AI算力
北京经济技术开发区发布《AI4Chip人工智能赋能集成电路产业跨越式发展行动计划(2026—2028)》,提出面向AI基础设施和智能体场景发展通用GPU、训练与推理ASIC、RISC-V AI芯片、高端CPU、存储器及硅光互联等配套产品。本文进一步分析其对算力平台、软件生态和采购验证的影响。
芯片与硬件AI算力影微创新全国总部在无锡梁溪科技城启用,当地将其作为端侧大模型AI芯片环节纳入算力、模型、芯片和终端的全栈产业体系。本文进一步分析其对算力平台、软件生态和采购验证的影响。
芯片与硬件AI算力无锡企业深存科技发布AI及数据加速处理器LakeTi P220和大模型可扩展计算平台XThor X400。当地披露上半年智能算力总规模为15619P,并形成多项垂直行业模型。本文进一步分析其对算力平台、软件生态和采购验证的影响。
芯片与硬件AI算力芯擎科技宣布7纳米车规级AI加速芯片“天工100”进入量产并批量供货,采用通过PCIe接入车载系统的独立加速器形态,面向新车和存量车型提供端侧大模型算力。本文进一步分析其对算力平台、软件生态和采购验证的影响。
 芯片与硬件壁仞科技
大会期间,壁仞科技全景式呈现技术创新的硬核实力: 重磅首发推出NPO光互连、分布式解耦架构、最大1024卡超节点方案 ,并荣获世界人工智能大会SAIL奖系列荣誉。与此同时,壁仞科技与众多顶尖专家学者及产业界人士齐聚一堂,共话行业发展大势;近日,在2026世界人工智能大会上,中兴通讯联合曦智科技、壁仞科技以及多家合作伙伴, 凭借“基于OEX+dOCS架构的国产高性能Matrix超节点”项目荣登SAIL榜单,斩获本届SAIL之星奖项 。
 芯片与硬件超节点
7月17日-20日,2026世界人工智能大会(WAIC)正式在上海拉开帷幕,壁仞科技正式推出 下一代NPO光互连、分布式解耦架构超节点方案,支持单个超节点1024卡Scale-up扩展 。壁仞科技联合创始人、首席技术官洪洲与AI框架架构副总裁丁云帆分别发布重磅演讲,系统展示了壁仞科技从芯片、协议、系统到应用的完整1024卡超节点方案。7月18日上午,洪洲在《优化GPU超节点——GPU芯片互联技术创新与工程实践》主题演讲中,系统性地阐述了
 芯片与硬件AI算力
长鑫科技于2026年7月27日在科创板上市。相比单纯讨论股价,更值得关注的是募集资金、先进DRAM工艺、产能建设以及AI服务器内存需求之间的产业联系。
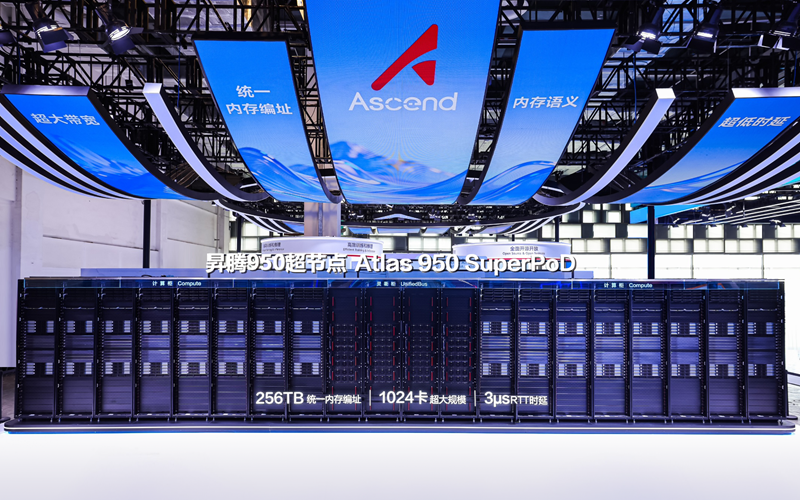 芯片与硬件昇腾950
华为在2026世界人工智能大会展示Atlas 950 SuperPoD真机,系统规模达到1024卡,并公布FP8、FP4算力、全局统一内存和互联时延等关键指标。
 芯片与硬件摩尔线程
摩尔线程公布基于PH100芯片和平湖架构的MTT S5000,覆盖FP8至FP64,并强调PyTorch、vLLM、SGLang适配及集群扩展。
 芯片与硬件壁仞科技
为夯实国产算力人才培育根基,实现人才能力与产业需求的精准匹配,壁仞科技联合模力方舟于近期重磅推出 AI技能认证 。目前,壁仞科技认证专区 初级L1认证 已面向在校学生及中级开发者开放。作为国内领先的通用智能计算解决方案提供商,壁仞科技本次推出的AI技能认证体系具备四重核心价值:。