 算力基础设施沐曦
资讯 · 算力基础设施
沐曦共建国产算力联合创新中心:C600从单卡验证走向集群服务
联合创新中心围绕曦云C600开展系统调优和大模型推理验证。对采购方而言,重点从单卡参数转向集群稳定性、调度效率与实际服务成本。
沐曦股份官方新闻2 分钟
算力基础设施沐曦联合创新中心围绕曦云C600开展系统调优和大模型推理验证。对采购方而言,重点从单卡参数转向集群稳定性、调度效率与实际服务成本。
 算力基础设施曙光8000
曙光发布围绕8000系统的技术解密活动。超大规模算力涉及计算、互联、存储和液冷协同,规模数字不能直接换算为业务吞吐。
 算力基础设施中科曙光
FN Neo面向推理中间数据提供共享存储,覆盖块、文件和键值接口。本文梳理它与本地NVMe的区别,以及长上下文集群怎样评估缓存复用收益。
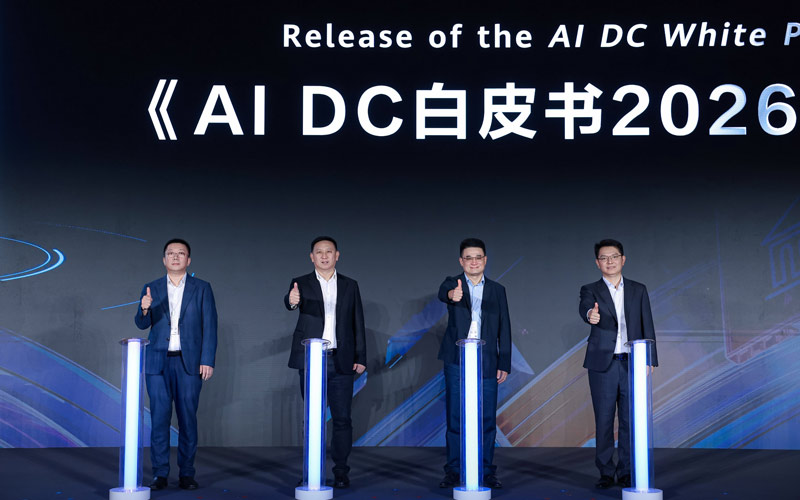 算力基础设施AI DC白皮书
华为在全联接大会发布AI DC白皮书及企业AI算力运营方案,将智算超节点、鲲鹏、高性能存储、无损网络、边缘推理和数据中心设施纳入统一架构。
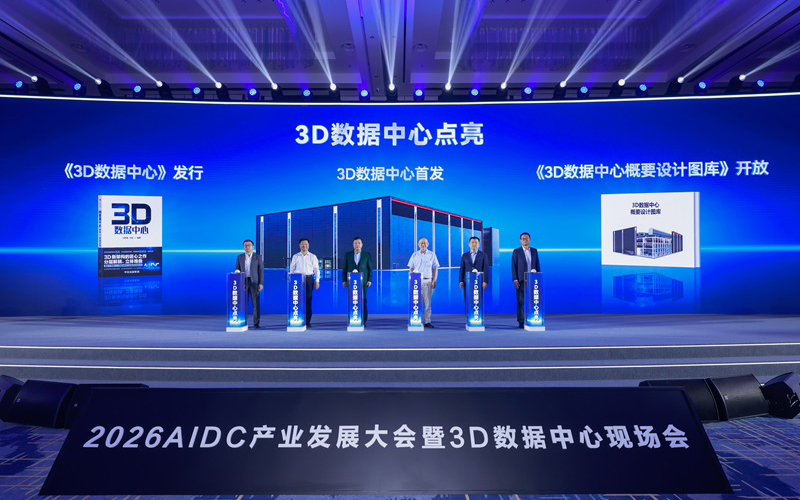 算力基础设施3D数据中心
华为发布采用四层垂直架构的3D数据中心,将供冷、IT设备、供电和备电空间分层解耦,面向高密AI算力中心的散热、安全与快速交付。
 算力基础设施scaleFabric
曙光公布scaleFabric Token加速技术体系,介绍GDR、IBGDA与远端存储访问优化。GPU主动驱动通信的价值,需要结合MoE路由与集群拓扑评估。
 算力基础设施阿里云
阿里云宣布进入Gartner云AI基础设施魔力象限领导者类别,其能力覆盖IaaS、PaaS和MaaS,反映云算力竞争正延伸至模型与平台工具链。
 算力基础设施开发者云
开发者云降低接触国产GPU的门槛,但试用前仍需核对资源规格、镜像、网络、计费与数据清理规则,避免测试无法复现。
 算力基础设施AI算力
移动云长三角(苏州)Token中心揭牌,提出从算力互联、模型汇聚和应用赋能三个方向建设,并通过模型服务网统一纳管和调度并网算力。本文进一步分析其对算力平台、软件生态和采购验证的影响。
 算力基础设施AI算力
截至2026年6月底,我国智能算力规模达到2185 EFLOPS(FP16),同比增长177%,算力设施整体上架率为71.4%。本文分析这些指标对算力供给和项目选型的实际意义。
 算力基础设施摩尔线程
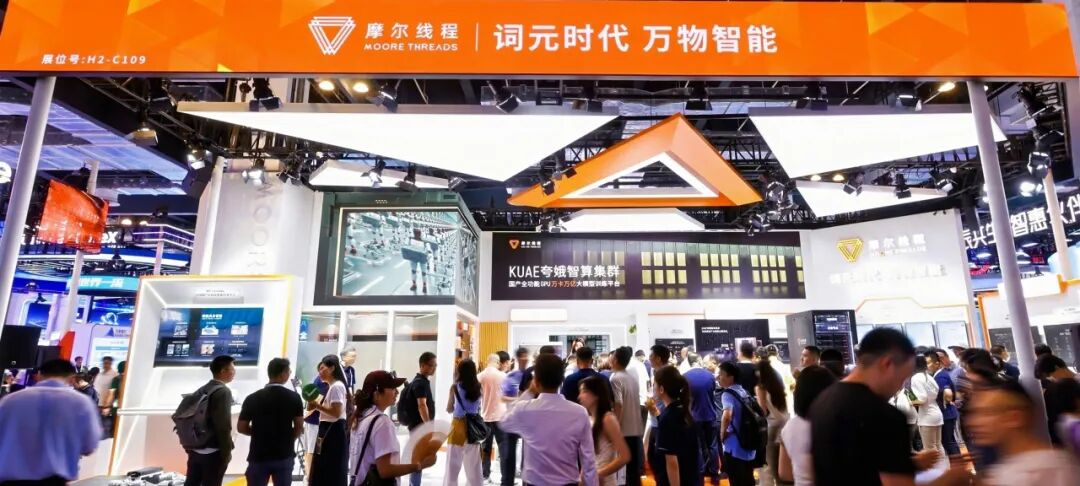
从双展区到主题论坛,从硬核产品、标杆案例到生态联动,摩尔线程 以“展区可感、论坛可知、生态可验证”的立体化呈现,向产业界展示了国产 GPU 从底层芯片、万卡集群到全场景落地的完整能力闭环。这不仅是摩尔线程全栈通用技术实力的集中展现,更标志着全功能 GPU 正全面迈入赋能企业实际应用的高质量规模化落地阶段。在 WAIC 展区,除了智算卡、服务器到边缘与智能终端的硬件矩阵展示,摩尔线程还将算力转化为“三大 AI 工厂”直观的空间交互,系统呈
 算力基础设施AI数据中心
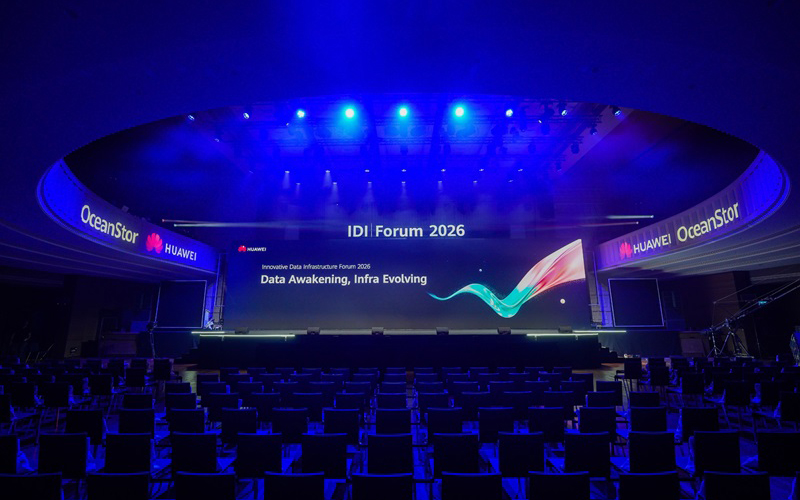
华为提出面向企业AI规模化落地的数据中心建设框架,将数据湖、知识与记忆平台、算力、模型、Agent框架和数据韧性纳入统一规划。
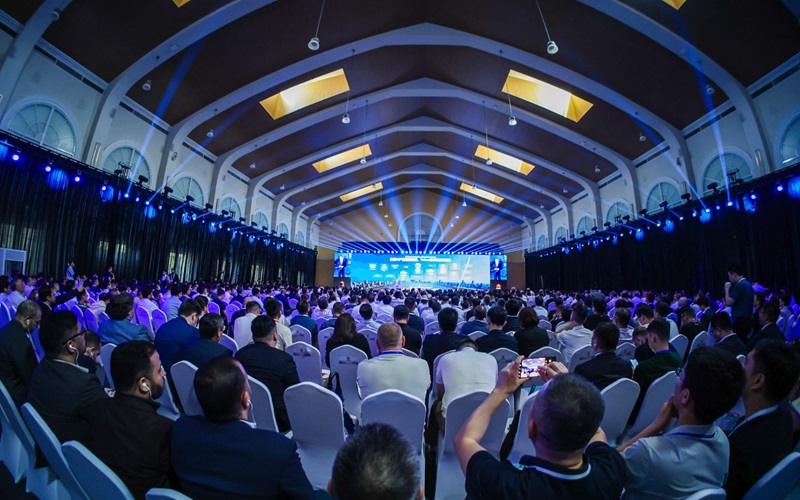 算力基础设施AIDC
面对超节点功率密度上升,华为提出源网荷储协同的AIDC方案,强调供电、制冷、储能和算力负载需要统一规划。
算力基础设施AI算力华为在MWC 2026发布Atlas 950 SuperPoD、Atlas 850E及TaiShan超节点产品。官方称Atlas 950以单柜64卡为基本单元,最大支持8192张NPU高速互联。本文进一步分析其对算力平台、软件生态和采购验证的影响。
 算力基础设施智算集群
华为发布端到端算力部署与优化服务,覆盖机房基础设施、集群集成、模型适配和性能调优,并披露1024卡超节点上线周期等工程数据。
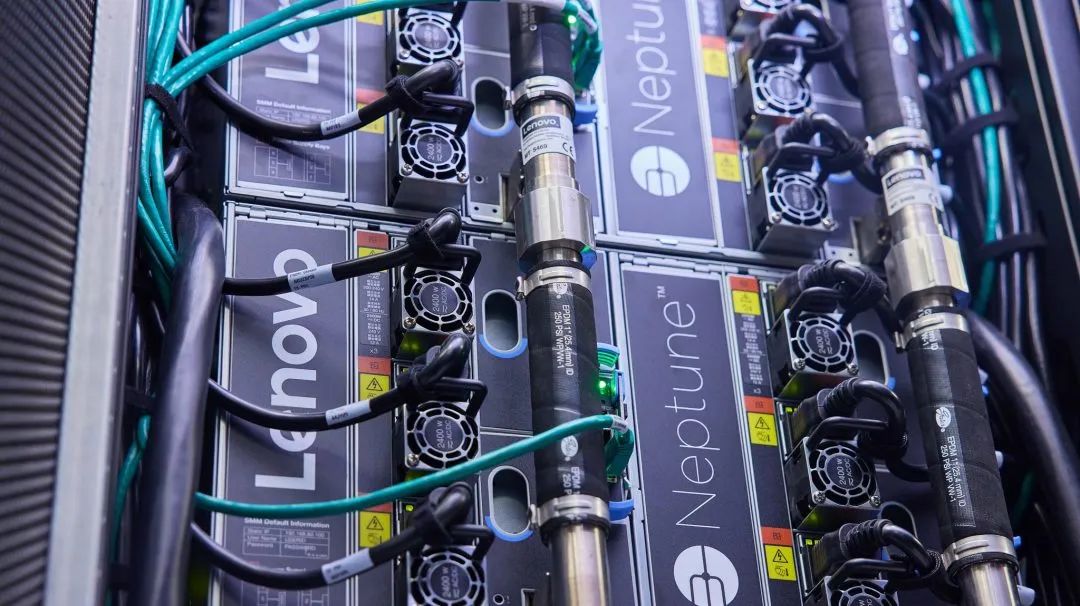 算力基础设施联想问天
联想问天海神方案覆盖服务器、歧管、CDU与液冷机柜。结合原厂资料,梳理一次侧与二次侧边界、漏液检测和机房改造时需要核对的条件。