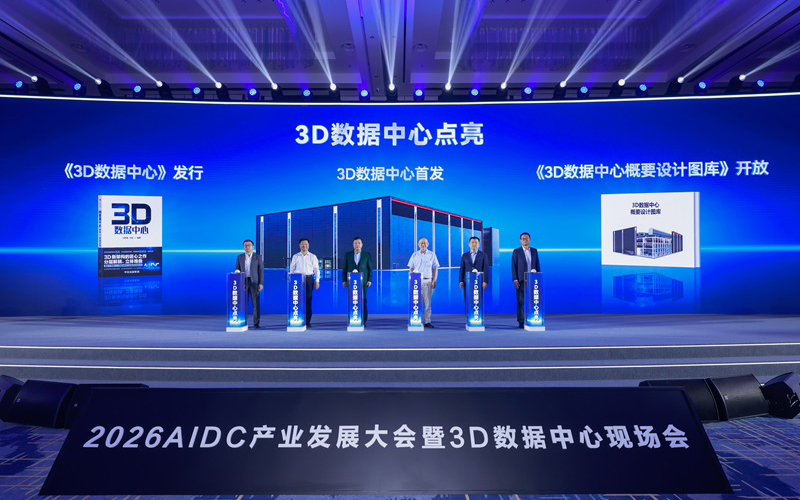
中科曙光9月23日发布曙光8000相关纪录片启播与技术解密活动的消息。官方以计算、网络、存储和液冷四个子系统介绍大规模工程。系统规模是供应方公开资料,本文不将其换算成某个模型的实际训练或推理速度。
曙光介绍系统包含十万张芯片、13440个计算节点,计算、网络、存储与液冷负责人共同讲解工程组织。数值来自官方消息而非本站现场测量。规模扩大后,组件制造、部署布线、冷热管理和运行监测必须形成统一工程。对于最终用户,应继续追问可用资源、支持的软件、任务恢复和服务交付,不能从芯片总数直接推导某个模型的训练时间。
大规模首先放大故障概率
卡数增加后,即使单个组件可靠,整体系统也会更频繁遭遇设备、网络或软件异常。检查点、重试、任务重调度和备件体系必须成为架构组成部分。一个能启动的大作业,和能够连续运行数周的大作业,是两个不同的工程目标。
网络也不能只看端口速度。集合通信、跨机路由、拥塞和拓扑影响训练同步;推理则可能受到专家路由或缓存迁移影响。采购方需要查看实际拓扑与指定负载,而不是用所有链路带宽的相加结果代表有效通信能力。
中小项目能从中学到什么
不必照搬超集群,但应采用同样的系统视角。两卡工作站需要检查电源与机箱风道,八卡服务器需要检查NUMA、PCIe和网卡路径,小型集群也需要考虑共享存储和恢复。硬件数量不能替代这些基础工作。
建议把方案拆成资源清单、容量账本、正常请求、故障恢复和长期运维五份材料。任何规模的算力采购,都应证明资源能够稳定完成目标任务,而不是仅证明设备数量足够。公开工程介绍的参考价值正在这里:提醒使用者把“系统可用”放在“参数漂亮”之前。
来源、翻译与版权说明
来源:中科曙光官方新闻。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- ZH
- 原文更新时间
- 2026-09-23
- 许可证
- 摘要引用与独立评论