 模型部署Open WebUI
知识 · 模型部署
Open WebUI连接内网vLLM:容器网络、账户、模型列表与持久化
用同一Docker网络连接聊天界面和推理服务,避免localhost指向错误容器,保留账户数据库,并检查模型列表、流式输出与升级回滚。
网昱算力学院 · 技术编辑6 分钟
模型部署Open WebUI用同一Docker网络连接聊天界面和推理服务,避免localhost指向错误容器,保留账户数据库,并检查模型列表、流式输出与升级回滚。
 推理与性能优化PostgreSQL
从本地数据库到BGE-M3向量入库建立完整检索链路,保留原文页码与模型版本,先验证精确搜索,再判断是否需要近似索引。
 推理与性能优化vLLM
使用JSON Schema限制模型输出结构,配合业务校验处理缺失字段、格式正确但事实错误和输出截断,不把合法JSON当成可靠业务结果。
 推理与性能优化vLLM
在共享基础模型上挂载两个兼容LoRA,验证模型列表、目标名称与任务结果,控制并行适配器和rank,避免把动态加载接口直接交给普通用户。
 推理与性能优化Qwen3 Embedding
用两个0.6B模型搭建召回后重排流程,明确查询指令、候选数量和评分格式,检查截断、中文任务和整体延迟,而不是把重排分数当作概率。
 集群运维与排障SSE
编写SSE流式客户端,正确解析增量文本与结束标记,区分连接超时和生成停顿,检查客户端取消后的服务器资源回收,不盲目重试长任务。
 模型部署Qwen3-8B
从独立容器和本地权重开始部署Qwen3-8B,区分普通回答与思考模式,检查接口、显存、输出截断和模型版本,避免只跑通一条请求就投入使用。
 模型部署Qwen2.5-VL
将Qwen2.5-VL部署为内网识图接口,使用Base64传输本地图片,设置输入限制,并用细字、旋转和无目标样本检查视觉预处理与输出质量。
 模型部署BGE-M3
用FlagEmbedding和FastAPI建立BGE-M3向量服务,明确1024维稠密向量的含义,限制批量与输入,并检查查询和文档是否使用相同模型版本。
 模型部署faster-whisper
部署本地语音转写流程,将音频转为带时间戳字幕,区分解码、VAD与识别耗时,检查长静音幻觉、术语错误和GPU依赖不匹配。
 模型部署Wan2.1
以Wan2.1的1.3B模型建立最小视频生成流程,记录代码与权重版本、固定种子,区分显存卸载和加速,并验证输出尺寸、时长与内容一致性。
 模型部署llama.cpp
从源码构建llama-server,使用官方Qwen GGUF权重,检查GPU卸载、模型名称、上下文和内存占用,区分CPU回退与真正的GPU推理。
 算力基础RTX 5090
用不同精度估算32B模型的权重底线,再把上下文、并发、运行时和供电纳入采购判断,说明为什么量化能装下不代表服务容量已经足够。
 算力基础RTX 4090
将三类显卡按模型容量、供电、服务方式和软件验证比较,区分专业卡不同版本,避免只按TOPS或“最大模型参数”选设备。
 算力基础超微主板
以超微官方两块工作站主板为例,区分Intel W790与AMD WRX80平台,检查CPU清单、内存类型、PCIe拓扑和显卡物理空间,不把插槽数量当作可装卡数量。
 算力基础NVIDIA L4
从模型容量、媒体任务、机箱风道和机柜功率比较L4与L40S,说明为什么低功耗多卡和较大显存少卡不能只按显存总和互相替代。
 算力基础双GPU
明确显存相加、模型分片和实例复制的差异,用拓扑检查与业务对照判断双卡是否值得,避免把PCIe x16和NVLink视为同一种互联。
 集群运维与排障AMD ROCm
使用AMD验证的ROCm PyTorch容器建立GPU环境,解释/dev/kfd、/dev/dri、HIP版本、设备权限和多卡验证,并避免把CUDA教程直接套到AMD平台。
 集群运维与排障Kubernetes GPU
从GPU节点驱动和设备插件开始,让Kubernetes上报nvidia.com/gpu或amd.com/gpu,编写最小测试Pod,并根据事件定位资源为零、Pod Pending和异构卡误调度。
集群运维与排障DCGM Exporter在每个GPU节点部署DCGM Exporter,通过9400端口输出Prometheus指标,解释温度、功耗、显存、PCIe、Xid和健康指标,并设计避免告警噪声的规则。
推理与性能优化大模型压测建立可复现的大模型API压测矩阵,区分首Token、逐Token、端到端延迟和吞吐,并通过固定请求率、真实长度分布和质量回归确定生产容量。
 集群运维与排障PyTorch
从宿主机驱动到PyTorch张量、混合精度和多GPU通信逐层验收,解释nvidia-smi、nvcc与torch.version.cuda为何可能显示不同版本。
算力基础KV Cache解释KV Cache由层数、KV头、头维度、精度、上下文和并发共同决定,并用加载前后显存与阶梯压测校正理论容量。
 模型部署Qwen3-32B
在两张同型号GPU上部署Qwen3-32B,说明权重容量、KV Cache、PCIe/NVLink拓扑、张量并行启动、接口验证和单卡量化替代方案。
推理与性能优化TensorRT-LLM依据新版trtllm-serve流程,从NGC容器启动OpenAI兼容服务,验证health、metrics和聊天接口,并用固定请求率建立性能基线。
集群运维与排障NVIDIA Container Toolkit面向Ubuntu GPU服务器,从驱动检查、官方软件源、Docker运行时配置到CUDA容器验收,解释宿主机CUDA与容器CUDA的关系,并给出常见故障定位顺序。
模型部署vLLM从GPU容器基线开始,用vLLM官方镜像部署Qwen兼容API,详细解释缓存、IPC、上下文、显存利用率、认证、流式请求、升级回退和OOM排查。
 推理与性能优化SGLang
以SGLang启动OpenAI兼容服务,解释静态显存池、张量并行、前缀缓存和请求调度,并给出从单请求到混合长度压测的完整验收路线。
集群运维与排障NCCL按单卡、点对点、单机集合通信和多机网络四层排查NCCL初始化卡死与性能异常,包含拓扑读取、共享内存、网卡选择、日志采集和nccl-tests基线。
 模型部署Ollama
面向工作站和小型服务器,用Docker运行Ollama并持久化模型,验证GPU是否真正参与推理,设置局域网访问边界,并排查模型落到CPU、下载重复和上下文OOM。
推理与性能优化AI算力为个人工作站或边缘设备选择合适GGUF量化并确定CPU与GPU分层策略,给出准备、实施、排错和验收方法。
推理与性能优化AI算力集群运维与排障AI算力集群运维与排障AI算力把新到货GPU服务器整理成可审计、可回滚、可交接的基础运行环境,给出准备、实施、排错和验收方法。
模型部署AI算力集群运维与排障AI算力模型部署AI算力在外网不稳定或生产环境隔离时可靠交付模型文件,给出准备、实施、排错和验收方法,并提供可复核的实施步骤、风险边界与验收标准。
模型部署AI算力模型部署AI算力将已确认许可和版本的模型转换成可重复构建的TensorRT-LLM推理引擎,给出准备、实施、排错和验收方法。
集群运维与排障AI算力选型与采购AI算力模型部署AI算力在AMD GPU服务器上建立可复核的PyTorch训练与推理基础环境,给出准备、实施、排错和验收方法。
 推理与性能优化AI算力
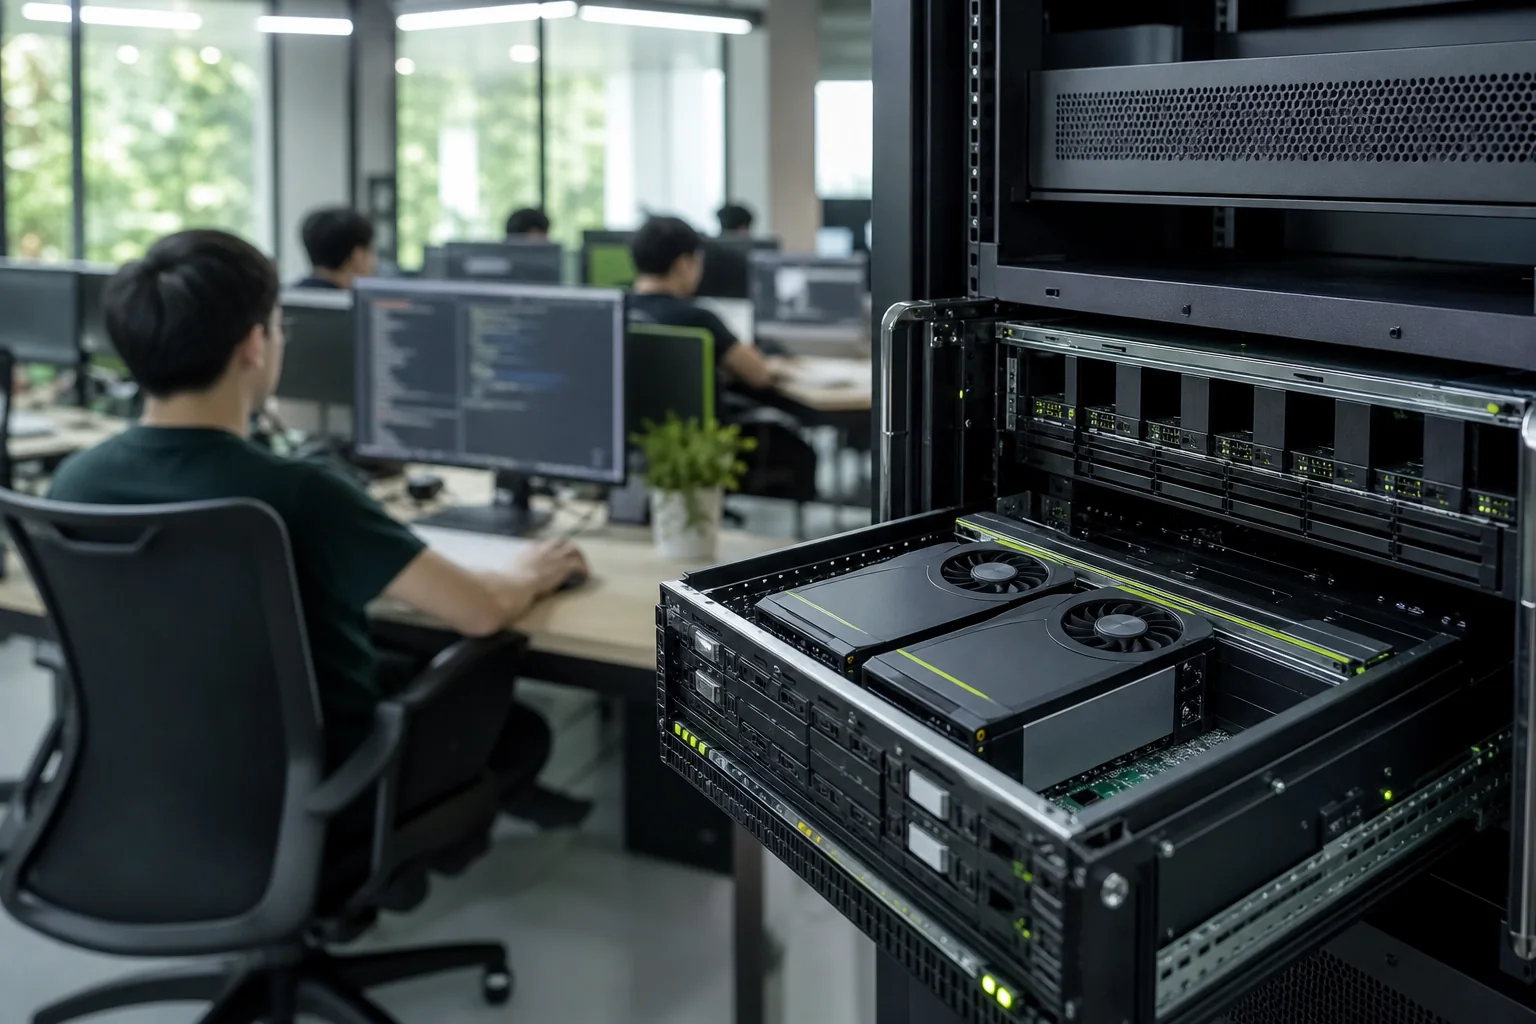
从单机验证走向生产服务,需要补齐容量测试、超时与限流、监控指标、故障恢复、灰度发布和回滚方案。本文提供一套可执行的上线检查流程。
集群运维与排障AI算力集群运维与排障AI算力解决nvidia-smi正常但容器看不到GPU、CUDA版本不匹配和框架启动失败,给出准备、实施、排错和验收方法。
推理与性能优化AI算力集群运维与排障AI算力在GPU掉卡、任务崩溃或节点异常时形成统一的XID故障响应流程,给出准备、实施、排错和验收方法。
推理与性能优化AI算力集群运维与排障AI算力 模型部署model-deployment
依据官方资料整理Qwen3 8B本地部署:Ollama安装、API调用与GPU检查的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
推理与性能优化inference-optimization依据官方资料整理Triton Inference Server部署:模型仓库、配置与动态批处理的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
 推理与性能优化inference-optimization
依据官方资料整理Transformers bitsandbytes量化:8位加载、4位配置与质量验证的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
 模型部署model-deployment
依据官方资料整理PEFT LoRA微调实践:数据准备、训练配置与适配器验收的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
算力基础compute-basics依据官方资料整理大模型显存怎么计算:权重、KV Cache、激活与运行余量的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
算力基础compute-basics依据官方资料整理FP32、BF16、FP16、FP8、INT8与INT4:AI精度格式选型的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
算力基础compute-basics依据官方资料整理PCIe、NVLink与NVSwitch:多GPU互联怎么影响训练和推理的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
选型与采购selection-procurement依据官方资料整理GPU服务器供电设计:整机功耗、PDU、冗余与上架验收的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
选型与采购selection-procurement依据官方资料整理AI服务器存储选型:模型加载、训练数据、检查点与共享存储的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
 选型与采购selection-procurement
依据官方资料整理AI服务器TCO计算:采购、电力、机房、软件与利用率的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
 选型与采购selection-procurement
依据官方资料整理GPU选型方法:从模型任务反推显存、算力、互联和散热的完整操作流程,包含环境检查、启动命令、参数说明、验收方法、故障排查和生产边界。
 模型部署DeepSeek-R1
依据DeepSeek官方模型卡与Ollama模型库,说明7B蒸馏模型的硬件选择、三种安装方式、模型下载、API调用、数据目录迁移、局域网访问、日志排错和安全设置。
模型部署DeepSeek-R1依据DeepSeek官方模型卡和vLLM服务文档,完整说明硬件评估、环境检查、模型下载、双卡启动、API验证、性能测试、常见故障与生产化注意事项。