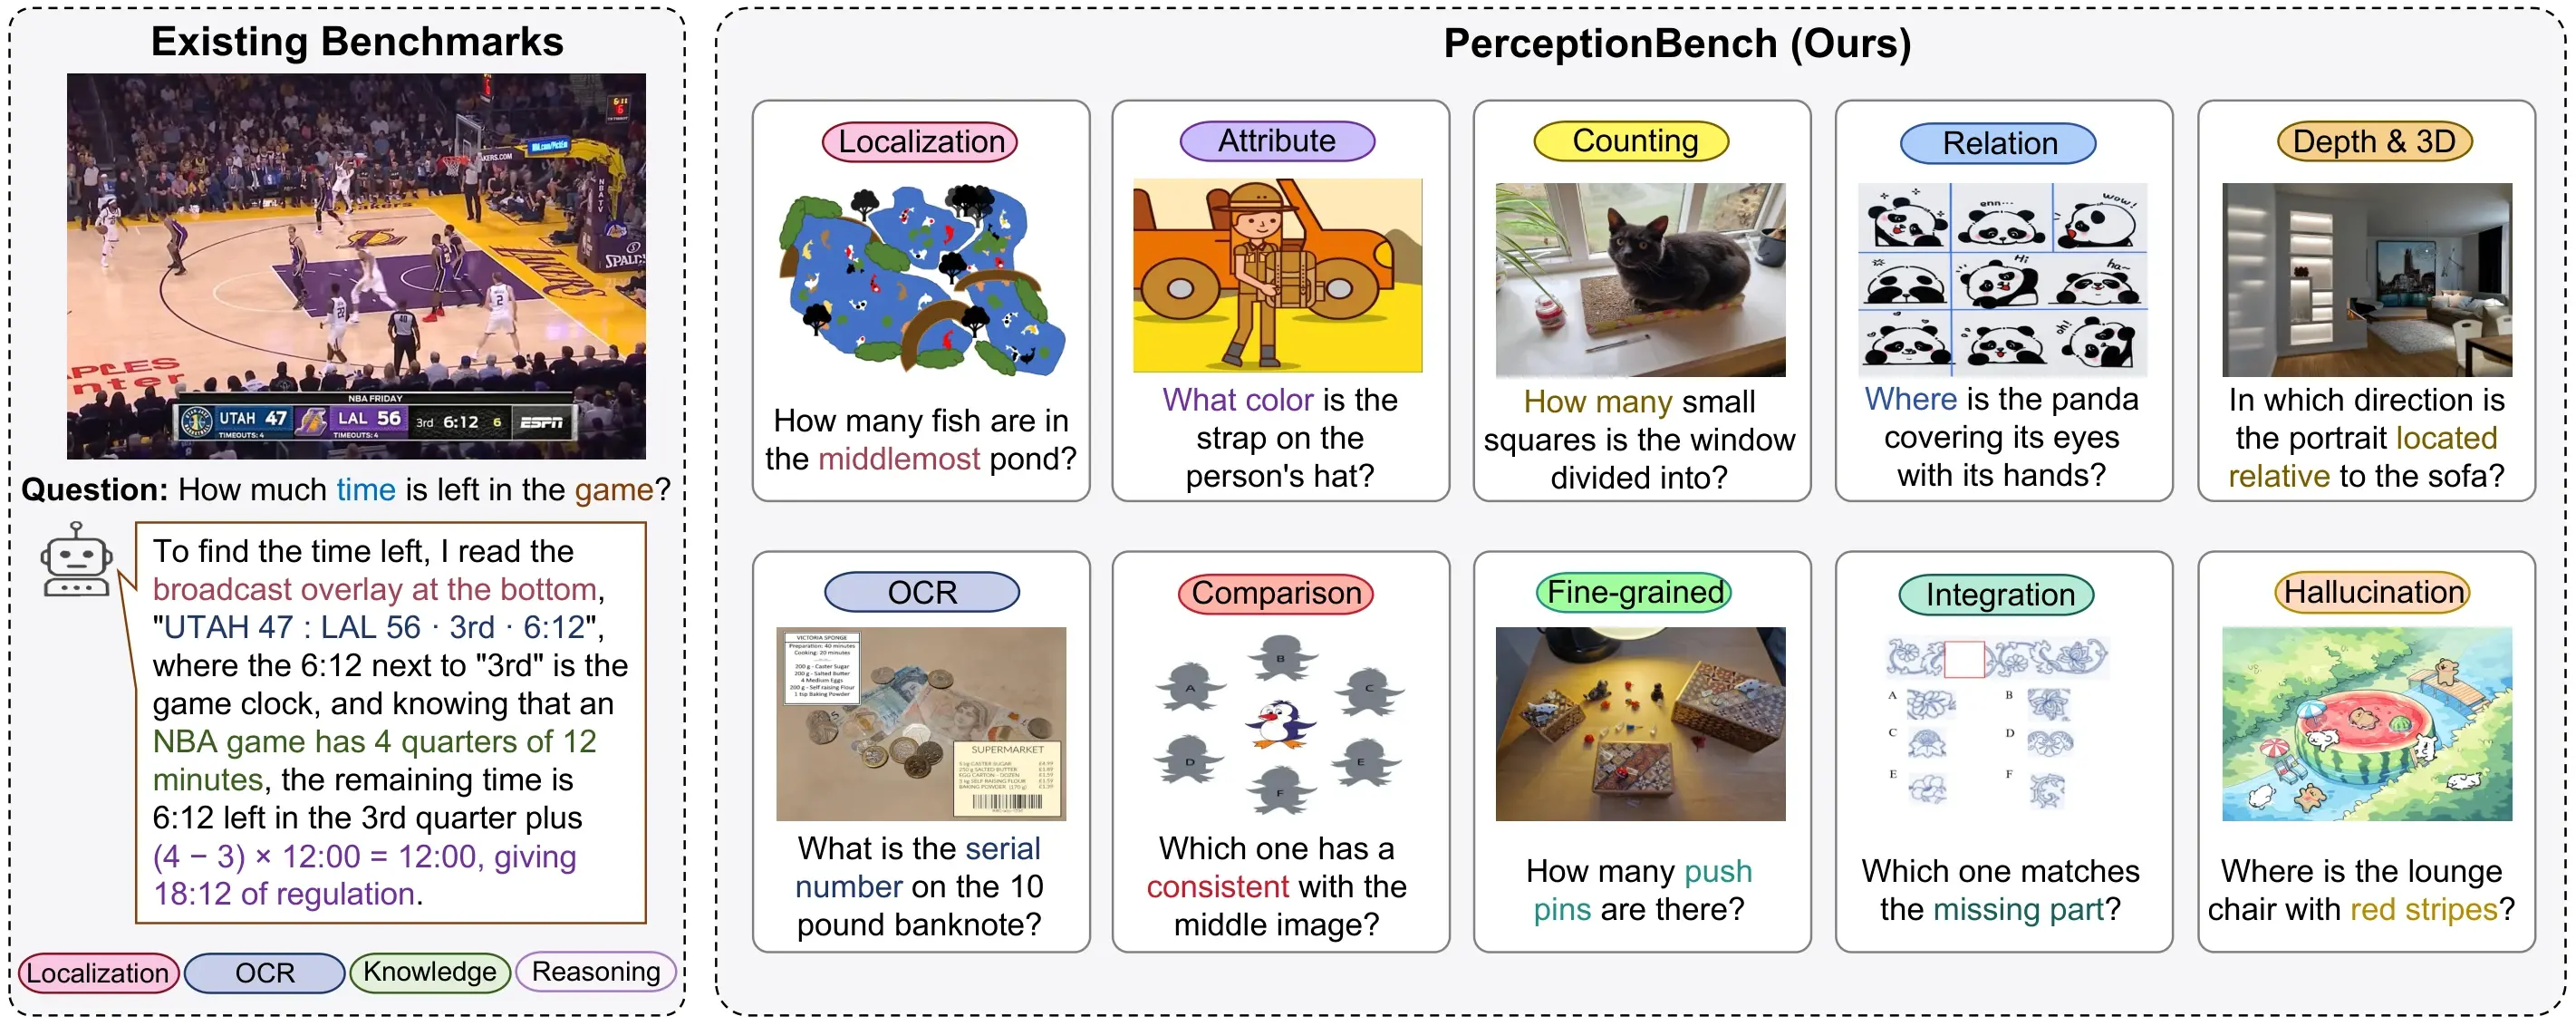
Kimi团队在官方研究页公布PerceptionBench,将视觉感知拆成十类原子能力,并构建3000道验证问题。研究强调尽量隔离推理与外部知识,让题目主要考察图像本身。本站依据公开研究整理,不把原站没有显示的发布日期虚构为今天。
团队从42个既有基准中的失败现象归纳分类,十类能力包括定位、计数、属性、深度、比较、细粒度识别、关系、上下文整合、OCR与幻觉。公开题目中60%来自拆解的模型失败、40%为新增问题,并对类别和难度平衡。团队报告所测16个前沿模型均未达到60%的总体准确率,这只代表论文指定评测条件,不是任意业务系统的准确率上限。
综合分数可能掩盖业务短板
两个模型的总分接近,可能在细字识别、计数和定位上表现不同。一个模型可以流畅描述图片,却看错仪表数字;也可能识别人物正确,却无法可靠判断区域内目标数量。业务应根据真实任务选模型,而不是用单一综合排名。
在工业巡检、档案处理和票据抽取中,这种差别会直接影响工作量。模型幻觉尤其危险:图片没有某个对象时,系统应能够回答“不存在”或转人工,而不是补出一个看似合理的描述。
将研究转化为自己的测试集
从业务中取出清晰、模糊、倾斜、遮挡和无目标五类图片,逐项标注真值。先测试原始图片,再测试部署时的缩放图片,观察预处理是否损失细节。OCR、计数与位置分别计分,错误样本留档,不只报告总平均。
对需要人工作出最终决定的项目,可让模型提供候选与证据区域,但保留原图供复核。本文不复刻整套题库,而是说明为何视觉系统验收需要能力拆分;完整方法与公开数据以Kimi原研究页为准。