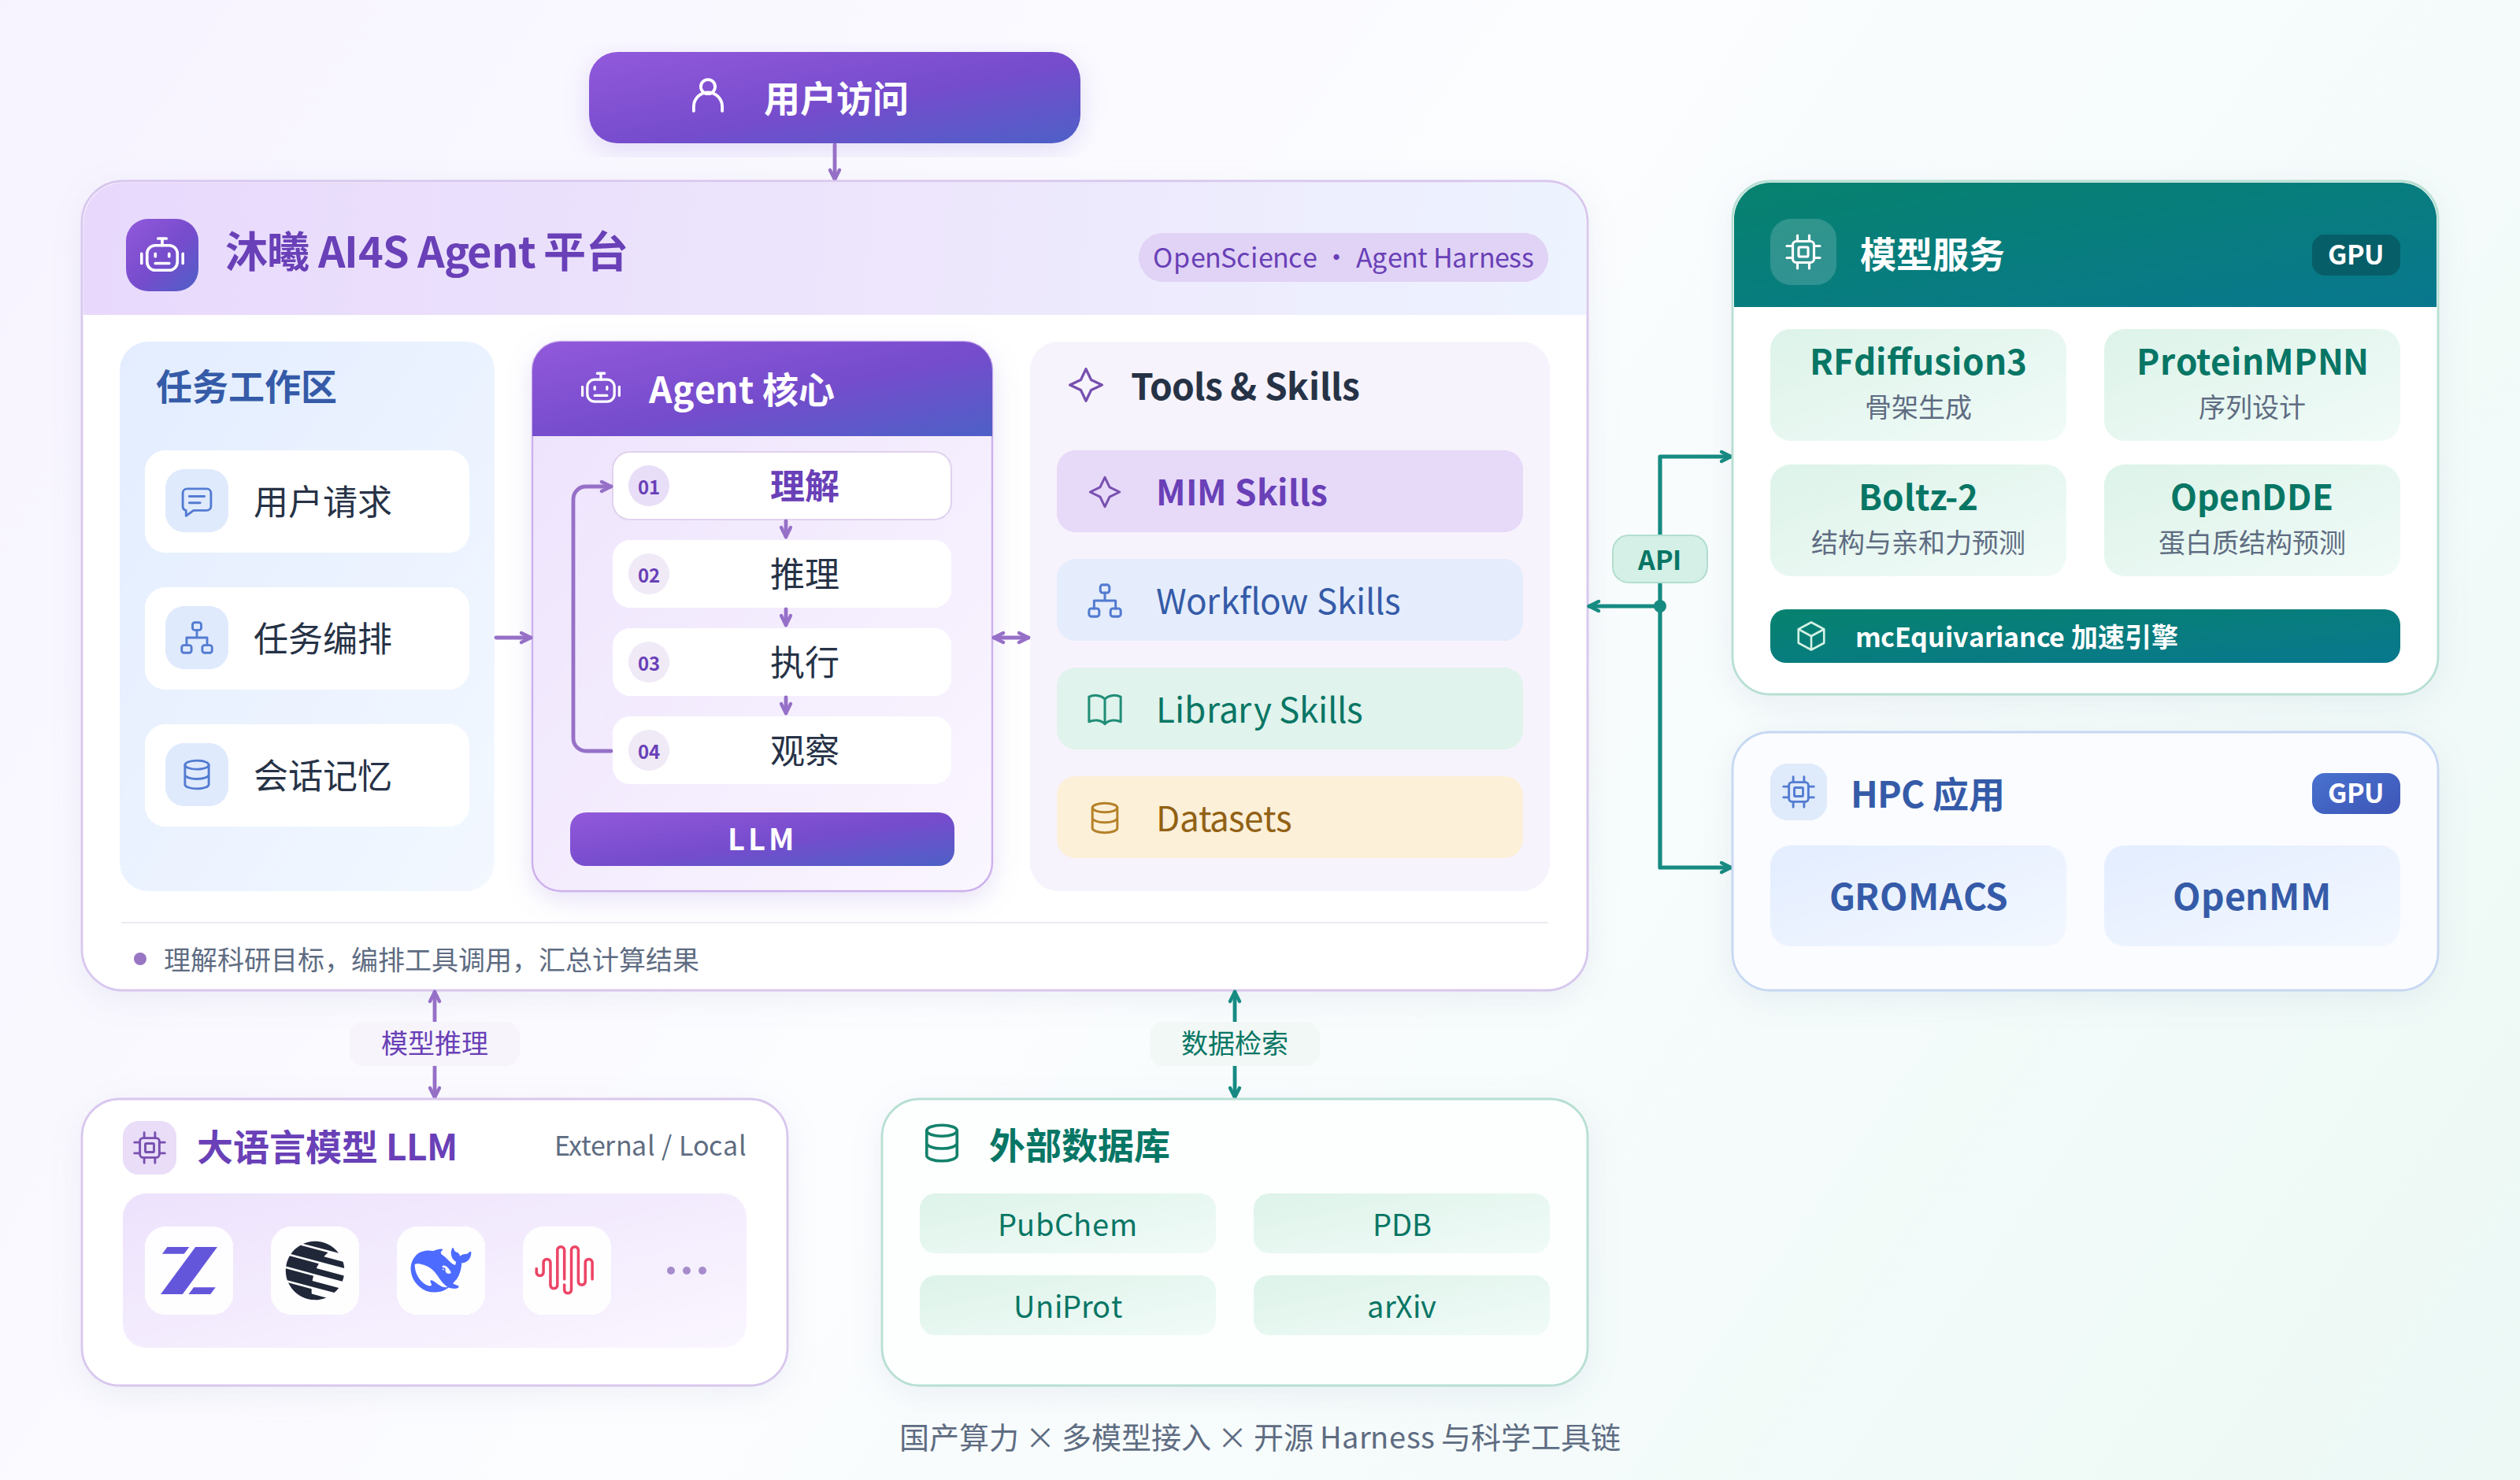
沐曦9月25日介绍AI4S科研智能体平台,以OpenScience运行框架连接大语言模型与生命科学工具。官方展示蛋白质结合剂设计工作流,并对加载与不加载工作流技能进行对照。该案例关注智能体能否按规范完成计算链条,而非证明生成候选已经获得实验活性。
科研Agent的难点在执行细节
一个科研任务往往需要准备结构数据、生成候选、设计序列、预测复合物、计算指标再筛选。语言模型可以描述这些步骤,但真正执行时,每个接口都要求文件格式、坐标体系、链编号和参数正确;上一步结果还必须作为下一步输入保存下来。
因此科研Agent更接近受约束的流程调度系统。它需要读取工具说明、调用已有计算服务、保存中间结果并检查返回状态。只生成一段看似专业的研究建议,无法证明流程已运行,也不能提供复现材料。
技能文件为什么能影响最终结果
厂商对照实验指出,缺少工作流约束时,智能体可能误将原始靶点和设计产物一起作为可优化对象,导致靶点被修改。这个错误发生在参数边界,后续即使顺利执行,也可能得到不符合任务要求的结果。
编辑分析认为,科研工具说明应明确允许变化的对象、固定输入和验证规则。对于结构文件,需要校验链、残基映射与坐标;对于筛选指标,要保存定义和计算版本。将这些规则固化,比要求模型“更仔细”更容易复现。
模型负责规划,专业程序负责计算
平台把大语言模型的任务规划与专业模型服务区分开。更换语言模型后,若工具接口与工作流规范保持稳定,科研流程有机会继续复用。但规划行为仍可能变化,不能仅因服务端点相同就省略回归测试。
建议从小规模、可人工核对的任务开始,要求每一步输出输入摘要、参数、运行状态和文件校验值。错误时保留已经成功的中间结果,确认是否能够断点续跑,而不是从头重复耗费GPU。
计算筛选成功与生物学有效不同
厂商验证使用结构置信度、界面误差等阈值筛选候选,并明确指出活性仍待湿实验验证。计算指标可以缩小搜索范围,但并不自动说明真实结合、表达稳定性或其他实验性质。
报道这类案例时,应同时保留失败靶点、筛选标准和负结果,避免只展示最优图片。实际研究需要进一步安排实验验证,并将反馈用于修正模型和管线。
高校或研发团队如何评估平台
先明确要节省的是操作时间、计算资源还是复现成本,再选择已有基线的任务。记录候选数、GPU小时、失败重试、通过筛选的比例和人工介入次数。交付物应包含输入版本、参数清单、中间结构、排序结果与运行报告,让另一名研究人员可以复跑并解释差异。
来源:沐曦官方新闻。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- ZH-CN
- 原文更新时间
- 2026-09-25
- 许可证
- 未登记