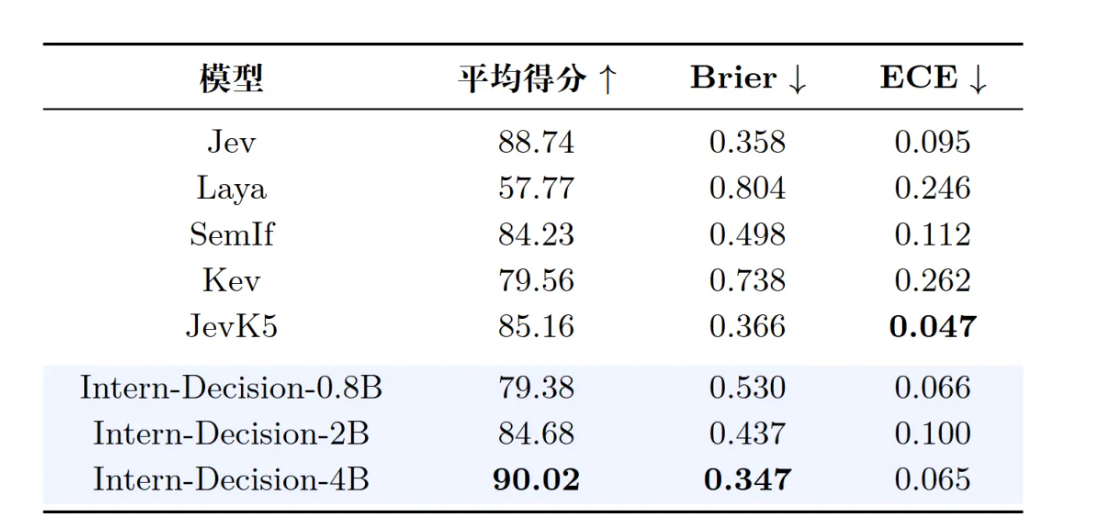
沐曦9月29日宣布完成上海人工智能实验室“书生·明决”Intern-Decision模型的Day-0适配。根据该官方发布,模型于9月28日开源,提供0.8B、2B、4B三档版本,面向结构化判断,并将视觉信息纳入决策。它为国产GPU生态增加了一种不同于长文本生成的模型任务。
输出选择,比生成解释更适合部分系统
许多业务最终需要的是一个类别、分数或动作,而非一段自然语言。例如客服问题应该进入哪个队列、检索结果是否相关、下一步是否需要人工处理。通用模型可以通过提示词输出JSON,但系统还需处理格式不稳定、冗长解释与重复生成。
编辑分析认为,小型决策模型值得在这类边界明确的任务中试验。应用先定义合法选项,再让模型给出结果,较容易形成确定接口。它不能因此替代所有推理工作:开放式方案设计、跨多份资料论证和长篇写作仍需要不同能力。
多模态决策怎样落到实际流程
若模型能够结合图片做选择,可以评估文档版式分类、界面状态识别和工业图像初筛等任务。这里的示例属于应用分析,并非厂商已完成的客户部署。输入图像尺寸、清晰度、类别定义和异常样本,会显著影响结果。
较稳妥的流程是先形成候选动作,再校验动作是否允许执行,必要时交由更强模型或人工复核。将模型判断与执行权限分开,有助于避免一次误判直接触发高成本操作。
概率高,并不自动等于可靠
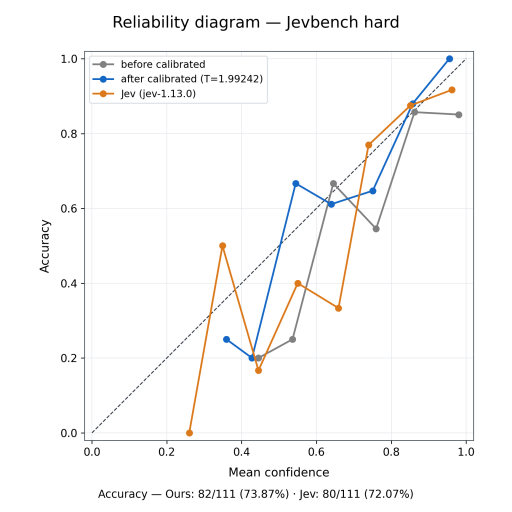
分类系统通常希望用置信度设定阈值:高置信结果自动处理,低置信结果升级复核。概率要经过校准才能与实际准确率对应。厂商报道也提及置信度校准实验;业务团队仍需用自己的样本检查高置信区间是否真的更准确。
测试集应按类别、图像质量与难度分层,统计混淆矩阵、误判率、拒判率和校准误差。对于类别极不均衡的业务,整体准确率可能掩盖少数关键类别的失败,应单独评价高风险类别。
小参数部署需要确认哪些成本
0.8B至4B的规模有利于探索较小显存配置,但准确容量仍取决于视觉编码器、精度、批量和输入长度。不要只用参数量乘权重字节数作为整机预算,还要留出运行时、激活和并发空间。
国产GPU验收可从单卡正确性开始,再测试批量吞吐与尾延迟。固定模型、提示模板和预处理,分别记录加载时间、每次判断耗时、功耗和错误返回。Day-0适配说明模型已进入平台支持范围,生产使用仍应锁定驱动、MXMACA与模型版本,并保留回归样本。
来源:沐曦官方新闻。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- ZH-CN
- 原文更新时间
- 2026-09-29
- 许可证
- 未登记