沐曦股份9月23日发布消息,宣布加入多元异构算力融合创新联合体。该消息显示国产算力生态的协作对象正在从单一芯片与单一模型,扩展到不同硬件、软件和行业应用之间的融合。联合体成立本身不等于不同GPU已经能够透明混用。
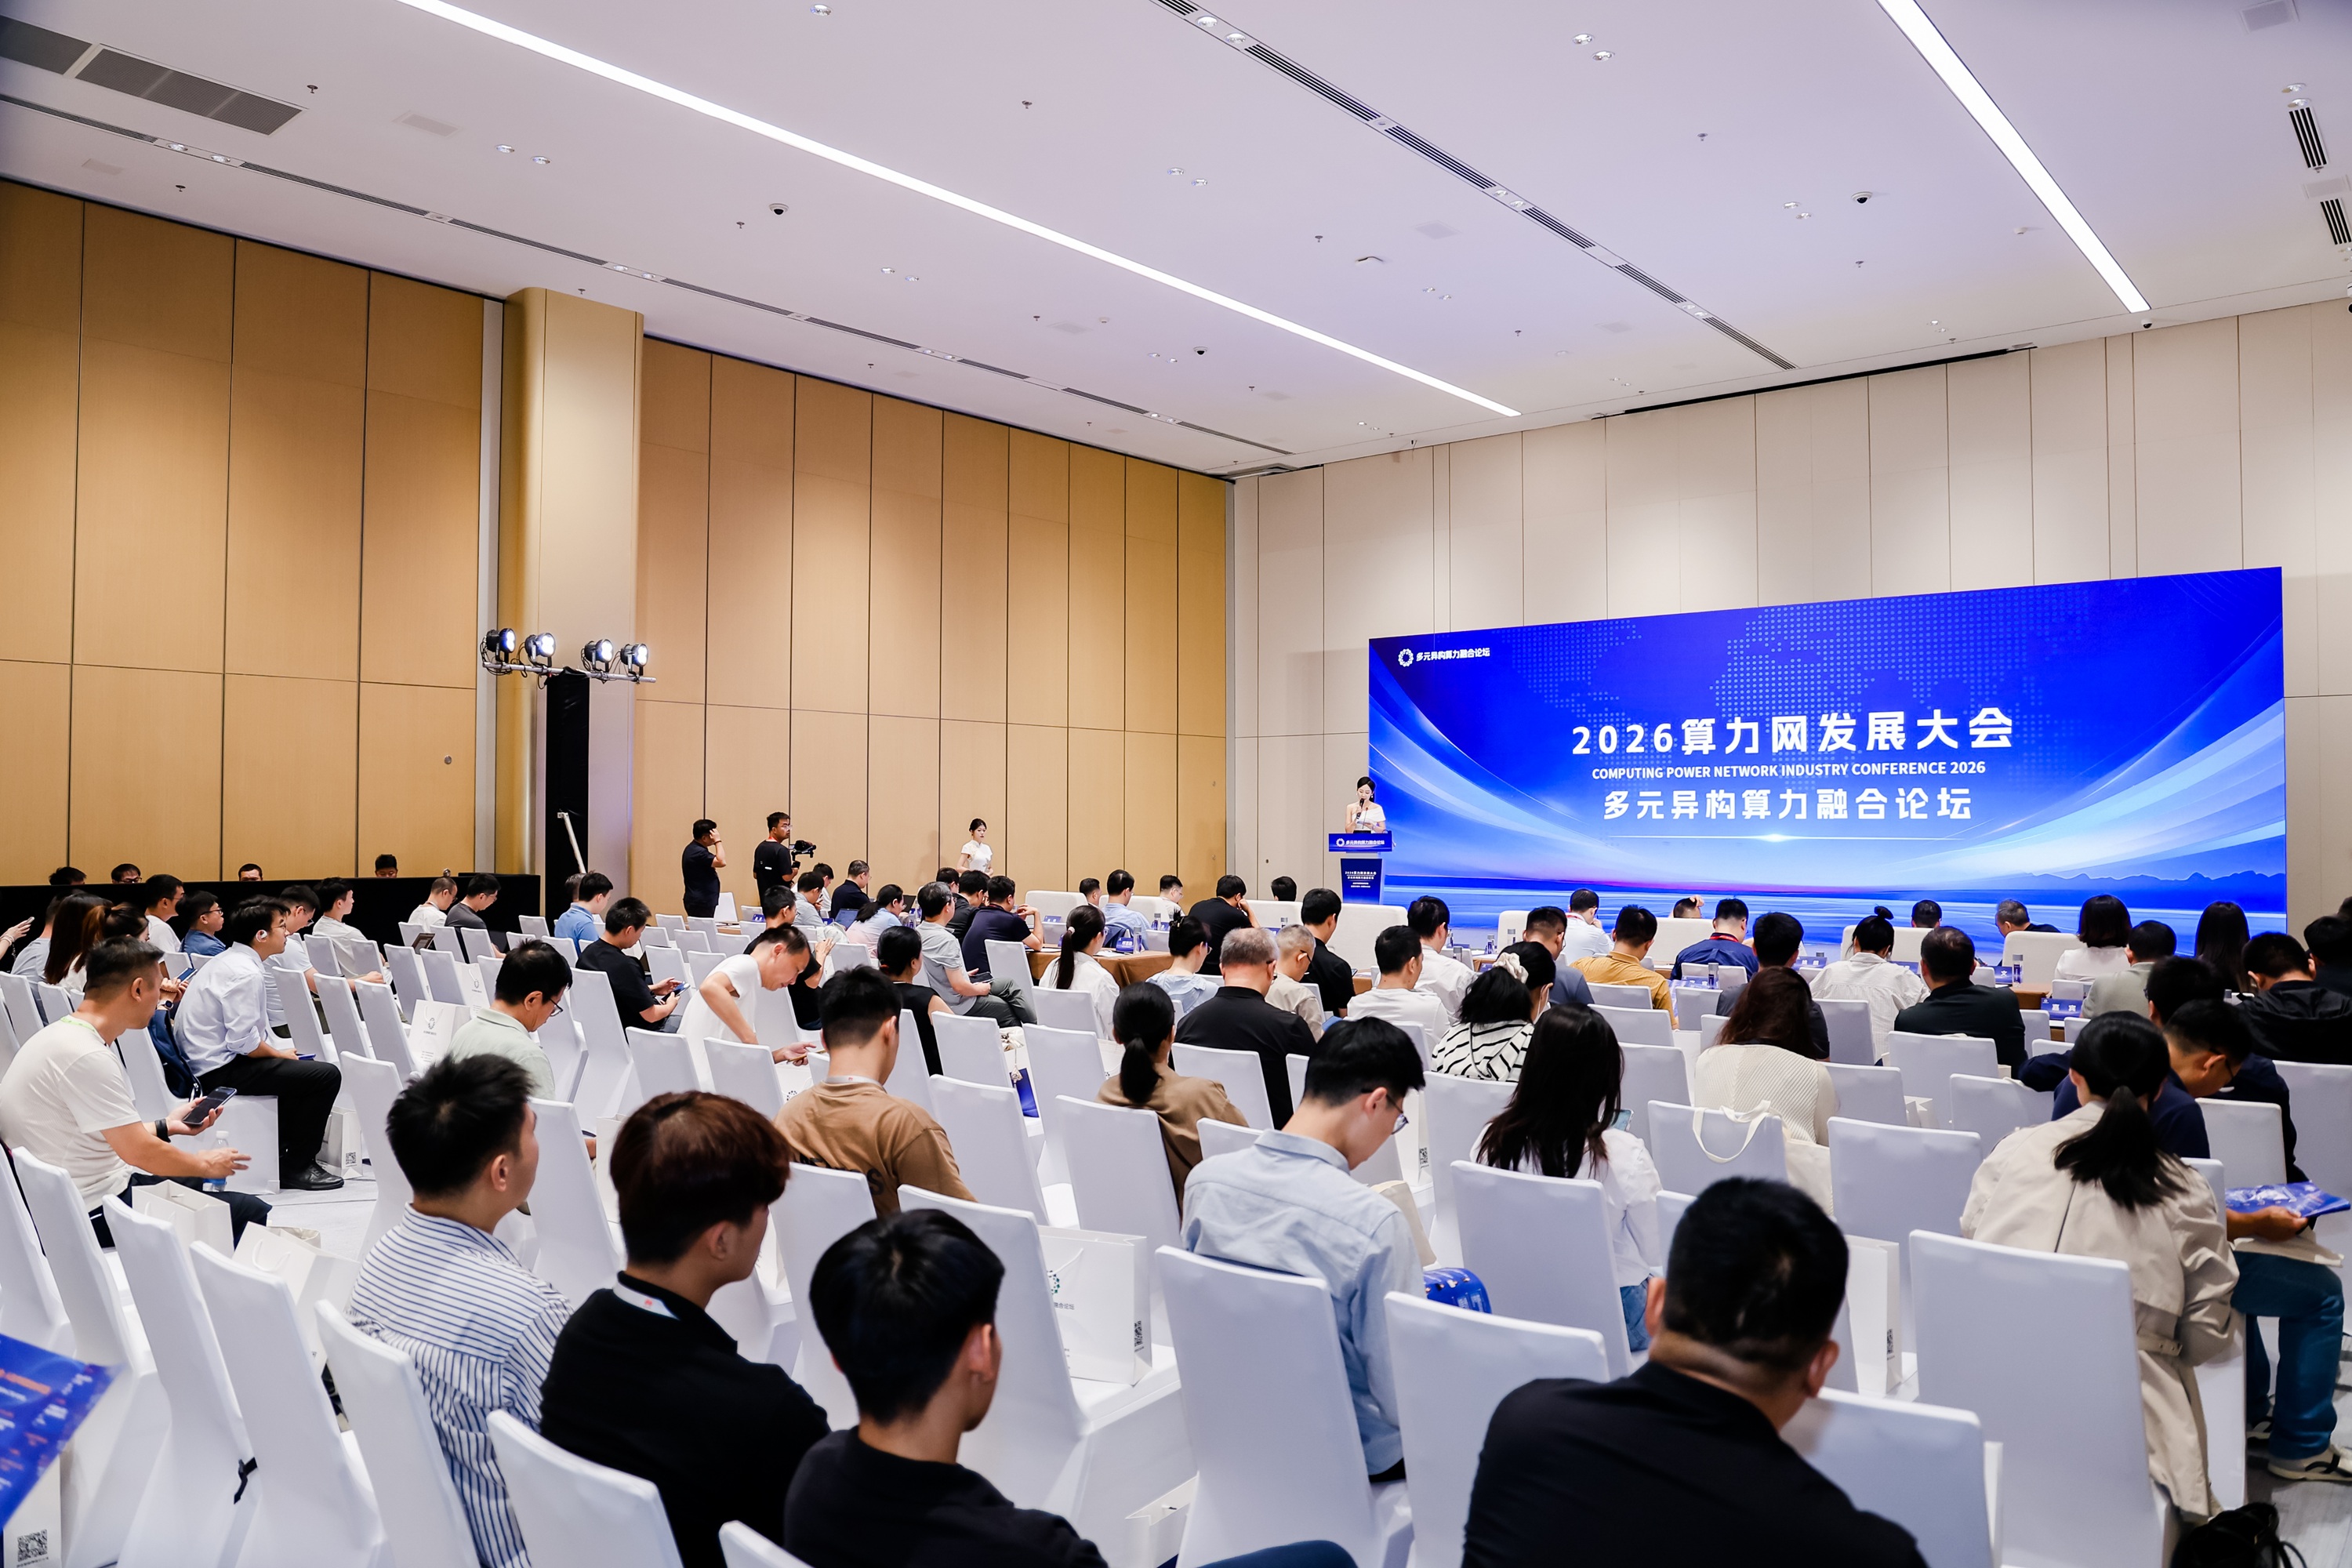
论坛于9月16日在北京举行,由中国信息协会算力网专业委员会主办,讨论技术路径、标准与协作。联合体通过的发展倡议覆盖资源标识、能力描述、服务接口、调用协议及认证鉴权等内容;后续方向还包括跨架构、跨区域的任务编排。沐曦在原文中提到与上海人工智能实验室、FlagOS等机构协作,并介绍DeepLink混合训练与推理方向。这里的重点是接口与验证体系,不是宣称所有芯片立即可以在一个任务里透明互换。
异构不是把不同显卡插进一台机器
应用层统一接口、调度层统一资源、执行层协同计算是三种不同目标。多个平台都提供兼容的HTTP接口,相对容易接入一个业务网关;让同一训练任务跨不同GPU进行同步计算,则涉及通信、精度、算子和性能均衡,难度明显更高。项目需求必须先说明自己需要哪一种能力。
对中小企业来说,较现实的路径是分离工作负载:文档解析、向量检索、离线生成和在线对话可以由不同资源池承担。只要数据格式、鉴权和日志规范一致,业务无需一开始就追求跨芯片张量并行。
防止迁移后陷入版本孤岛
采购验证应保留框架版本、驱动、编译器和模型revision。检查上游项目是否接受适配、是否有持续集成,以及升级失败时能否回滚。一个只能停留在旧分支的适配包,可能让后续安全修复与模型升级越来越困难。
因此,观察这类合作的后续成果,应关注公开接口、可复现示例、兼容矩阵和持续测试记录,而不仅是参与机构数量。对租赁客户,还应确认调度器分配的实际硬件型号与合同一致,避免“异构资源池”成为无法解释性能差异的理由。
来源:沐曦股份官方新闻。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- ZH
- 原文更新时间
- 2026-09-23
- 许可证
- 摘要引用与独立评论