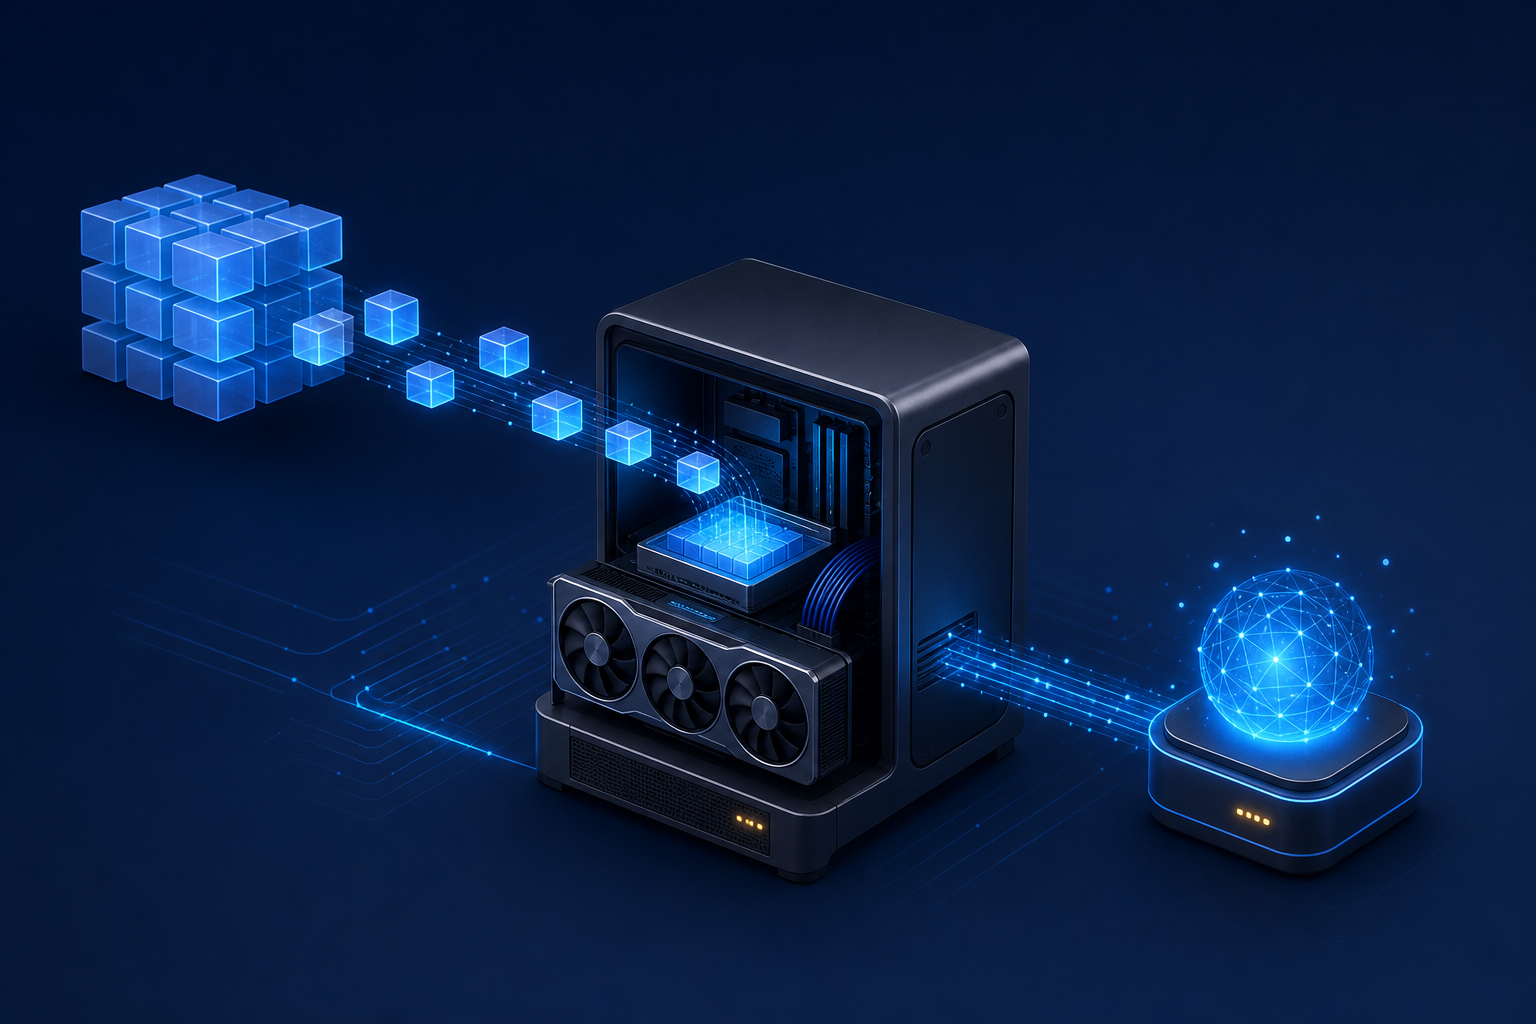
总显存不是默认统一地址空间
两张32GB卡的物理容量合计64GB,但普通单卡模型分配并不会自动跨卡借用空闲空间。需要框架支持模型分片、张量并行或其他策略,且每张卡都有运行时与缓存。最吃紧的卡可能先OOM,所以不能用整机总空闲显存判断任务一定能启动。
如果每张卡各跑一份小模型,是增加独立实例数量,不是增加单实例可用显存。双卡数据并行训练也通常复制模型与优化器状态,不能拿它来解决单卡放不下完整训练状态的问题。采购单中应明确所使用的并行方式。
互联先看实际拓扑
PCIe代际、链路宽度、CPU根端口、NUMA和P2P支持都会影响通信。x16外形不保证x16链路,经过芯片组或跨CPU也可能改变路径。GeForce与专业卡是否具有NVLink,必须核对具体型号,不能根据“高端卡”推断。
在Linux中保存nvidia-smi topo -m与lspci信息,检查GPU与网卡邻近关系。拓扑图用于定位,实际传输测试与模型测试仍然必要。不要为了追求P2P无条件关闭系统隔离功能,安全与整机厂商指导同样重要。
一个公平的双卡对照
先在一张卡上使用能装下的模型做基线,另一张卡关闭任务;再测双卡两个独立实例;最后测同一模型双卡分片。输入集、到达率、输出上限与质量要求相同,记录首字、完成量、尾延迟和逐卡显存。
如果模型单卡原本可以运行,分片可能增加通信而没有明显收益。若模型单卡无法容纳,双卡分片的价值可能是“能够运行”而不是翻倍加速。这两种结论应分开,不用一条总吞吐数字表达所有结果。
CPU卸载不是第三张免费显卡
把权重或状态放到主机内存会增加PCIe传输。它可以帮助容量受限任务,但交互时延可能变差,主机RAM与内存带宽也可能成为瓶颈。CPU卸载、统一内存和多卡并行是不同机制,不应混用术语。
双卡工作站还要核对槽位空间、电源线、供电回路和散热。故障演练中停止一个实例,确认另一个独立实例能继续;同一模型的分片实例通常会整体受影响,不能把两张卡视为高可用。最终交付包含拓扑、并行配置、请求集和日志。参考:vLLM并行策略。
来源:网昱算力学院 · 技术编辑。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- ZH
- 原文更新时间
- 未提供
- 许可证
- 原创工程内容