这份资料解决的问题
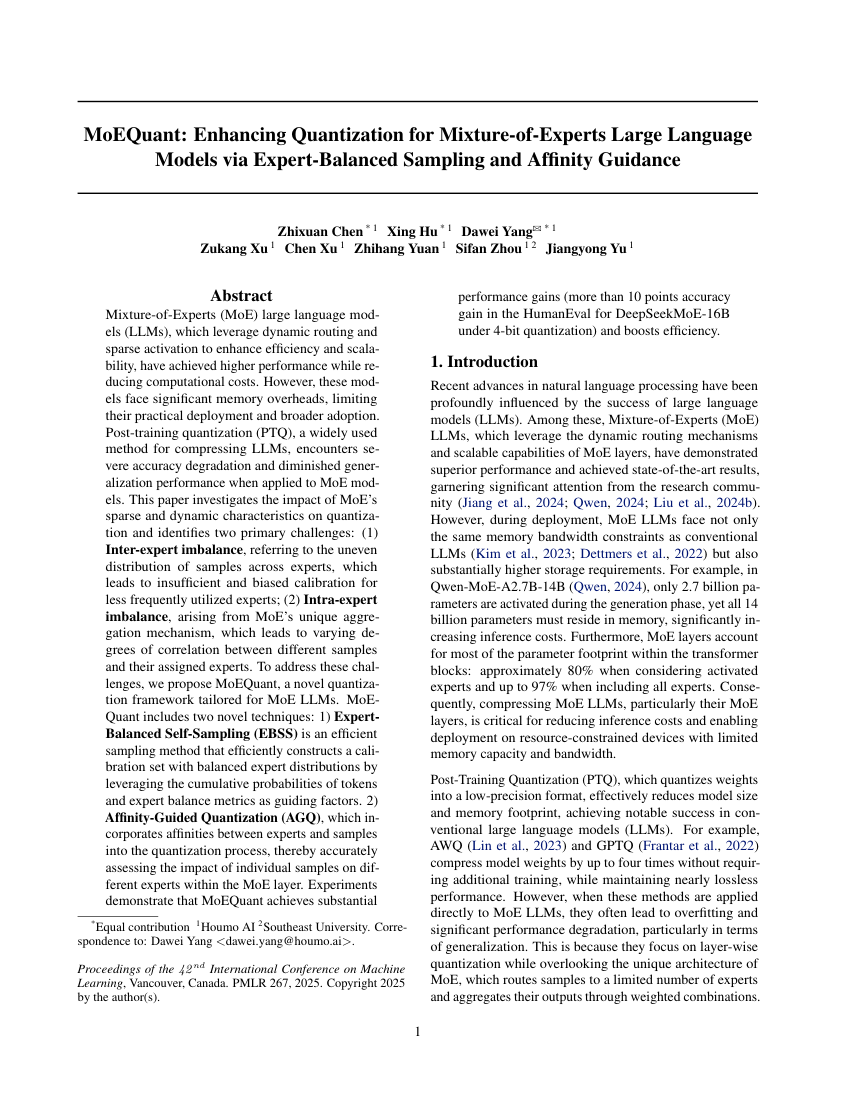
MoE量化的难点是校准样本经过动态路由后并不平均覆盖每个专家。MoEQuant分别处理专家之间和专家内部样本分布不均,强调校准数据与专家贡献的关系。准备量化部署时,应统计路由覆盖、低频专家与业务长尾任务,避免用一小批通用文本代表所有中文、代码和工具调用场景。
原始研究资料
原文题名:MoEQuant: Enhancing Quantization for Mixture-of-Experts Large Language Models via Expert-Balanced Sampling and Affinity Guidance。
作者:Zhixuan Chen、Xing Hu、Dawei Yang、Zukang Xu、Xu Chen、Zhihang Yuan、Sifan Zhou、Jiangyong Yu。
原始发表入口:MoEQuant: Enhancing Quantization for Mixture-of-Experts Large Language Models via Expert-Balanced Sampling and Affinity Guidance。本页上方提供完整、未经删改的原始PDF,可在线阅读或直接下载。中文文字是独立导读,不冒充全文译文;实验设置、算法公式、消融结果和附录以完整PDF为准。
引用与许可
原始文献及本文引用请保留作者、题名、原发表机构与原文地址。原文采用CC BY 4.0许可,本地副本保留原有署名和出版信息。
来源、翻译与版权说明
来源:PMLR。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- EN
- 原文更新时间
- 2025-07-13
- 许可证
- CC BY 4.0
- 文件校验
- 0bb42611635ccc99…