这份资料解决的问题
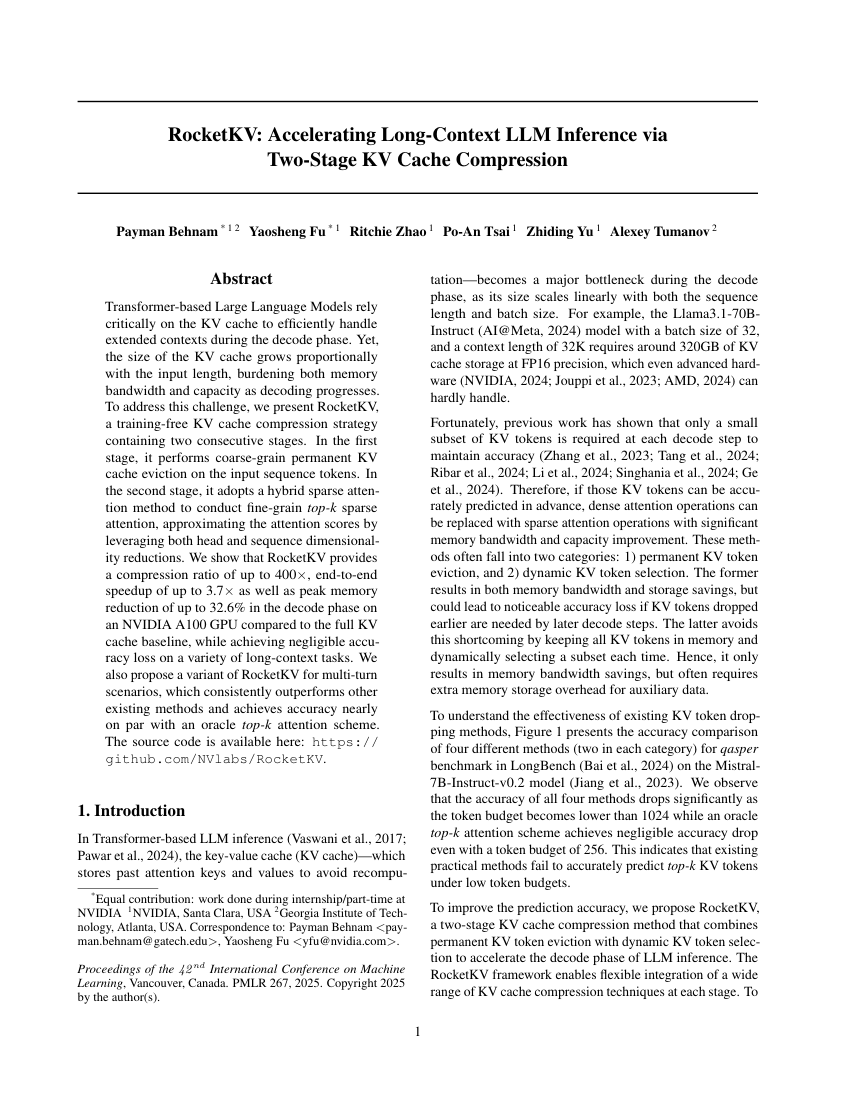
RocketKV将永久驱逐与细粒度稀疏注意力组合,重点降低长文本解码阶段的缓存压力。缓存压缩会改变模型可访问的信息,尤其需要验证跨段引用、数字提取和多轮追加的问题。论文包含不同压缩强度和任务结果,适合建立质量—显存—延迟的三维对照,而不是直接套用最大的压缩倍数。
原始研究资料
原文题名:RocketKV: Accelerating Long-Context LLM Inference via Two-Stage KV Cache Compression。
作者:Payman Behnam、Yaosheng Fu、Ritchie Zhao、Po-An Tsai、Zhiding Yu、Alexey Tumanov。
原始发表入口:RocketKV: Accelerating Long-Context LLM Inference via Two-Stage KV Cache Compression。本页上方提供完整、未经删改的原始PDF,可在线阅读或直接下载。中文文字是独立导读,不冒充全文译文;实验设置、算法公式、消融结果和附录以完整PDF为准。
引用与许可
原始文献及本文引用请保留作者、题名、原发表机构与原文地址。原文采用CC BY 4.0许可,本地副本保留原有署名和出版信息。
来源、翻译与版权说明
来源:PMLR。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- EN
- 原文更新时间
- 2025-07-13
- 许可证
- CC BY 4.0
- 文件校验
- 00bae59c63774ca6…