这份资料解决的问题
InternVL3研究怎样把视觉理解、语言能力和测试时推理结合起来。它适合用于分析文档图像、复杂图表与多图任务,不应只看综合榜单。实际项目需分别验证缩放后的细字识别、跨页信息关联、图表数值和无答案拒答;视觉编码器占用与语言模型缓存也应分开记录。
原始研究资料
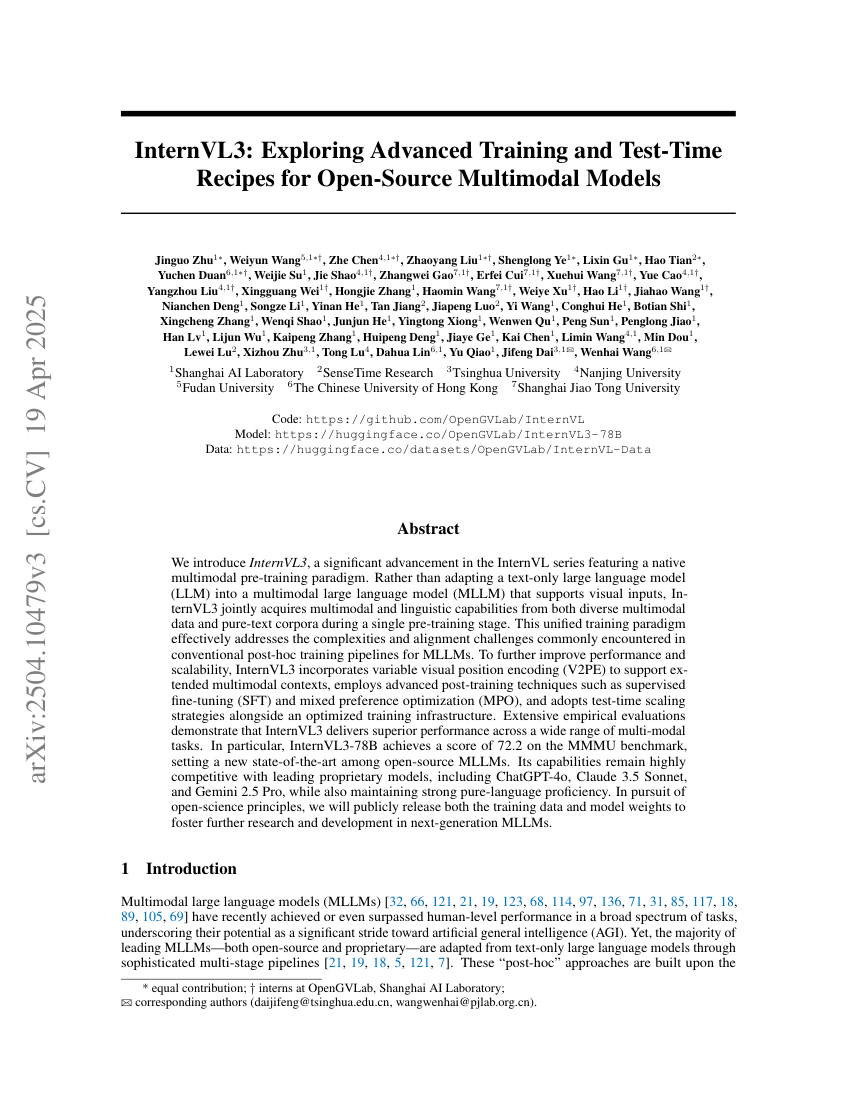
原文题名:InternVL3: Exploring Advanced Training and Test-Time Recipes for Open-Source Multimodal Models。
作者:Zhu, Jinguo、Wang, Weiyun、Chen, Zhe、Liu, Zhaoyang、Ye, Shenglong、Gu, Lixin、Tian, Hao、Duan, Yuchen等(完整署名见原文)。
原始发表入口:InternVL3: Exploring Advanced Training and Test-Time Recipes for Open-Source Multimodal Models。本页上方提供完整、未经删改的原始PDF,可在线阅读或直接下载。中文文字是独立导读,不冒充全文译文;实验设置、算法公式、消融结果和附录以完整PDF为准。
引用与许可
原始文献及本文引用请保留作者、题名、原发表机构与原文地址。原文采用CC BY 4.0许可,本地副本保留原有署名和出版信息。
来源、翻译与版权说明
来源:原作者 · arXiv。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- EN
- 原文更新时间
- 2025-04-14
- 许可证
- CC BY 4.0
- 文件校验
- 5da94f2a229808a4…