
场景不是单模型部署
企业平台可能共用一个基础模型,却为部门、客户或任务保留不同LoRA。适配器数量从几十增长到数千后,CPU内存、GPU缓存、加载延迟和热点淘汰会成为服务瓶颈。
系统思路
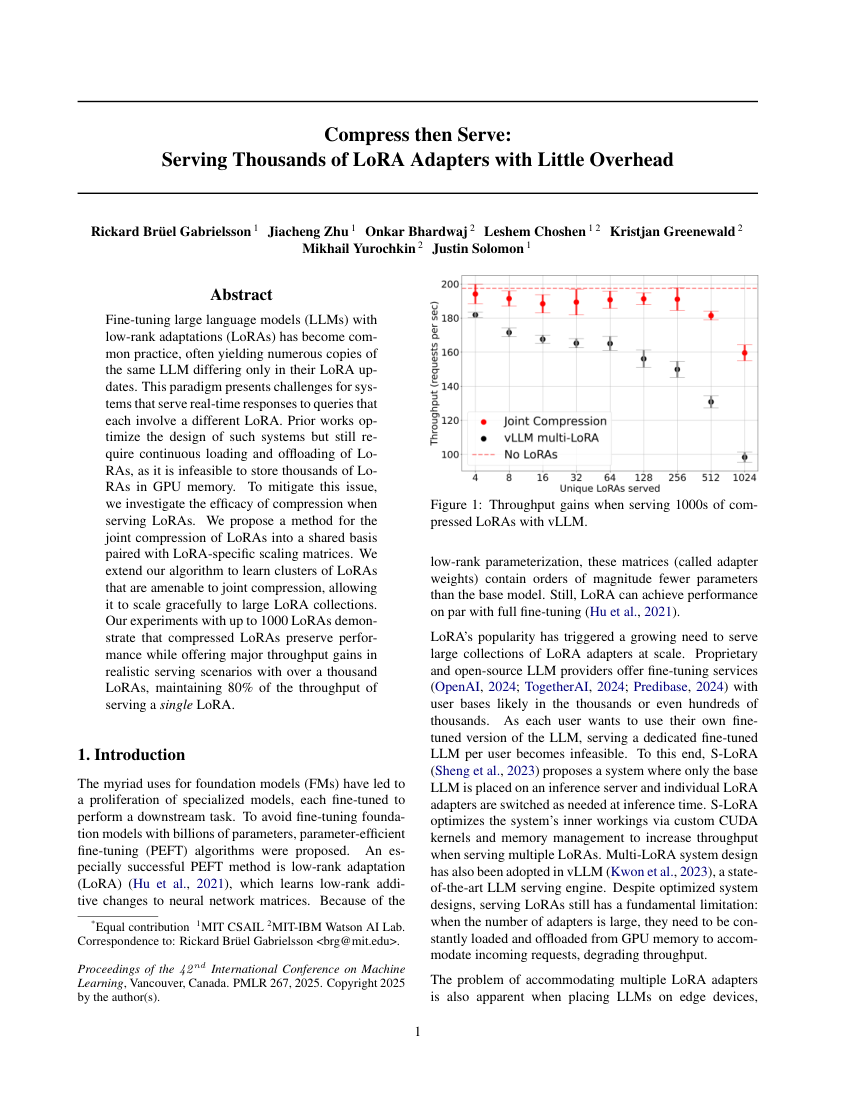
作者压缩适配器表示,减少存储与CPU到GPU的数据移动,同时让运行时按请求选择并组合适配器。论文的价值在于把压缩误差与真实服务开销放在一起评估,而不是只展示压缩比。
落地测量
测试应包含冷启动与热缓存两种路径,记录适配器大小、加载时间、命中率、并发吞吐、基础模型显存和任务质量。还要验证租户隔离,避免错误复用、版本漂移或适配器在请求之间串用。
完整原文与使用说明
原文题名:Compress then Serve: Serving Thousands of LoRA Adapters with Little Overhead。作者:Rickard Brüel Gabrielsson等。本站保存来源机构发布的完整英文PDF,PDF内容未作删改;上面的中文内容是针对这篇论文单独撰写的阅读导引,不冒充全文翻译。
原始发表页:https://proceedings.mlr.press/v267/gabrielsson25a.html。
许可依据:PMLR官方出版协议向公众授予CC BY 4.0许可,转载时须保留作者、出版信息和PMLR原文链接。 本页同时展示文件页数、大小和哈希值,便于核对本地文件完整性。
来源、翻译与版权说明
来源:Proceedings of Machine Learning Research (PMLR)。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- EN
- 原文更新时间
- 2025-07-13
- 许可证
- Creative Commons Attribution 4.0 International (CC BY 4.0)
- 文件校验
- 56b12a7b5ed33dc2…


