论文回答的实际问题
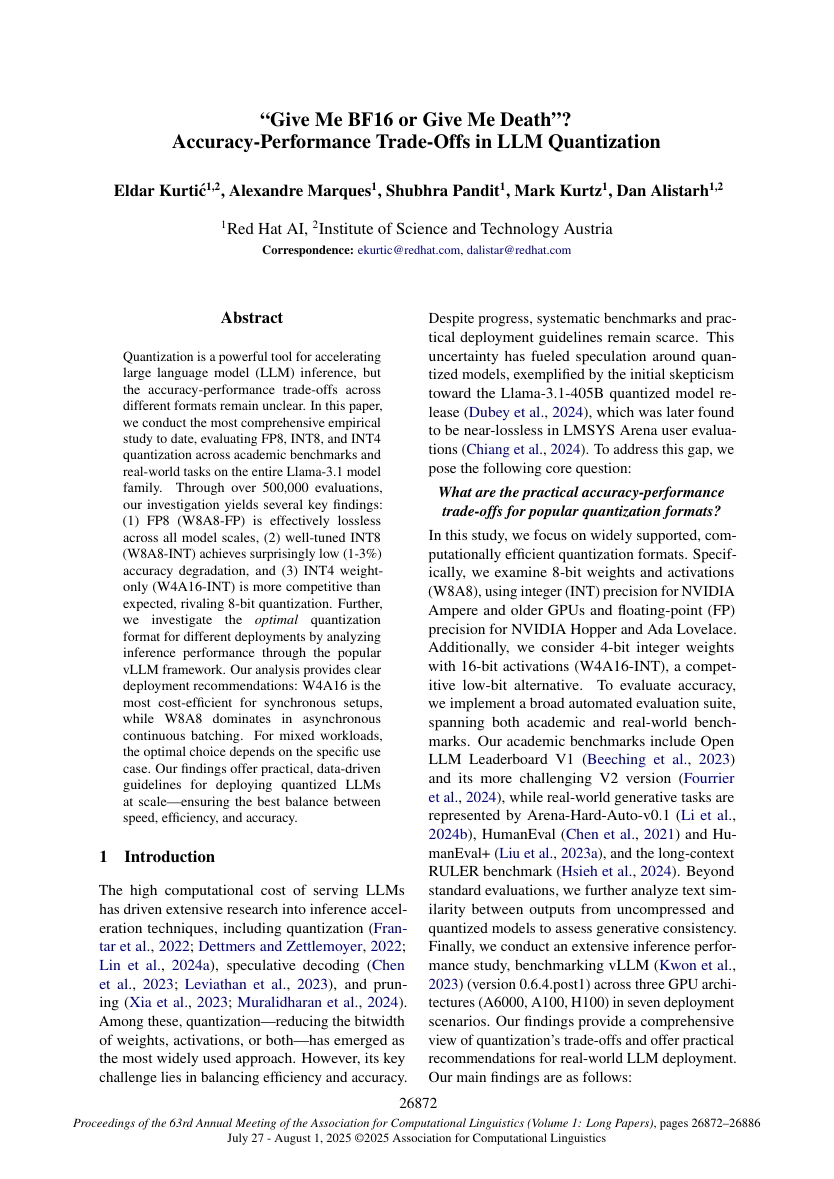
量化模型文件更小,并不自动意味着在线服务更快。低位格式只有得到目标GPU和推理框架的高效内核支持,才能转化为吞吐收益;反量化、内存访问和批调度都可能吃掉理论优势。
主要观察
实验显示FP8 W8A8在所测尺度上可以接近无损;经过调优的INT8 W8A8通常只有有限质量损失;INT4 W4A16在容量敏感场景仍有竞争力。不同GPU代际与同步、异步负载下的成本排序并不相同。
复现检查表
固定模型版本、Tokenizer和评测集,分别记录静态显存、KV缓存容量、首Token、每Token时延、并发吞吐、功率和单位百万Token成本。不能把困惑度或单个学术榜单当作中文问答、代码和工具调用的完整质量结论。
完整原文与使用说明
原文题名:Give Me BF16 or Give Me Death? Accuracy-Performance Trade-Offs in LLM Quantization。作者:ACL 2025论文作者。本站保存来源机构发布的完整英文PDF,PDF内容未作删改;上面的中文内容是针对这篇论文单独撰写的阅读导引,不冒充全文翻译。
原始发表页:https://aclanthology.org/2025.acl-long.1304/。
许可依据:ACL Anthology官方版权政策说明:2016年及以后发布的材料采用CC BY 4.0,可在保留署名与出处的前提下复制和再分发。 本页同时展示文件页数、大小和哈希值,便于核对本地文件完整性。
来源、翻译与版权说明
来源:ACL Anthology。第三方内容版权归原作者或发布机构所有;本站仅在许可证或明确授权允许时提供本地原文。
- 原文语言
- EN
- 原文更新时间
- 2025-07-01
- 许可证
- Creative Commons Attribution 4.0 International (CC BY 4.0)
- 文件校验
- d903a21d02185423…